

Дашборд Дженка: парадокс AI в embedded-мире
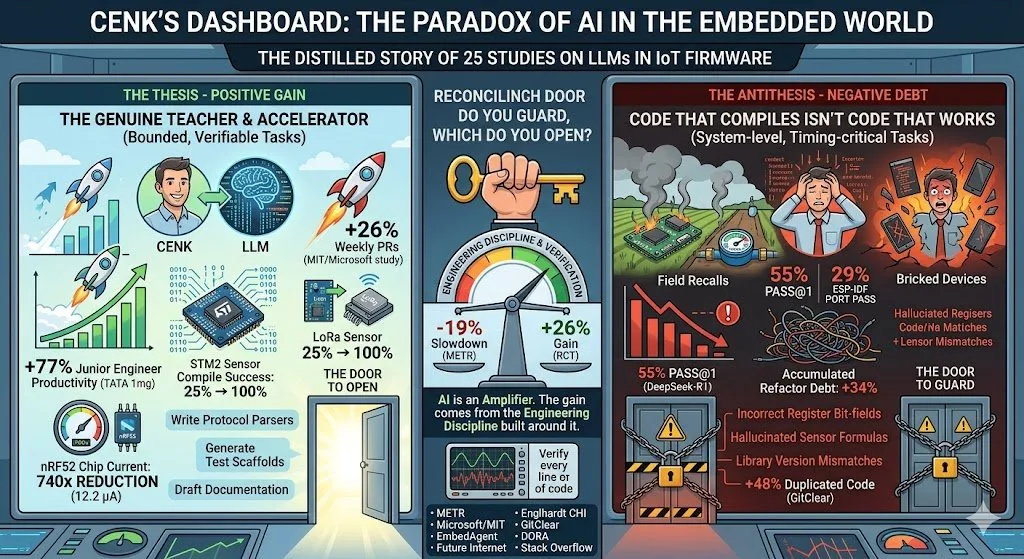
Квинтэссенция 25 исследований.
Вторник, утро, 9:14. В небольшом IoT-стартапе в Анкаре Дженк, senior firmware-инженер, смотрит на экран. Ему нужно настроить сэмплирование ADC через DMA на плате STM32. Он спрашивает Claude — код приходит, компилируется, прошивается. Датчики выдают данные. Дженк улыбается. На следующей неделе двенадцать умных водосчётчиков в поле начинают зависать в случайные моменты. Виновник: неверная конфигурация тактирования периферии. Компилятор этого не поймал; кремний — поймал. Дженк смотрит на свой дашборд и спрашивает себя: этот инструмент действительно нас ускоряет или просто создаёт ощущение скорости?
Дженк не одинок. Два самых резонансных исследования 2025 года открыто противоречат друг другу. В контролируемом эксперименте METR 16 опытных open-source-разработчиков выполняли задачи на 19% дольше при использовании AI-инструментов — хотя заранее предсказывали ускорение на 24%, а после всё равно считали, что работали на 20% быстрее. В том же году совместное RCT Microsoft, MIT и Принстона с участием 4 867 разработчиков измерило рост числа еженедельных PR на 26%. Два исследования, два противоположных направления. Какое из них доминирует в мире embedded-систем?
Инструмент действительно учит, ускоряет, демократизирует
Доказательства сильные. В исследовании Englhardt на CHI 2024 workflow «человек + AI» поднял долю успешной компиляции LoRa-датчиков с 25% до 100% — даже пользователи без опыта работы с железом смогли собрать рабочие датчики. В том же исследовании GPT-4 снизил потребление тока чипом nRF52 в 740 раз за счёт контекстно-зависимой оптимизации энергопотребления — до 12,2 микроампер. В годичном исследовании TATA 1mg среди 300 инженеров junior-разработчики показали прирост продуктивности до 77%. По данным DORA 2025, 90% разработчиков уже используют AI; 80% сообщают о положительном влиянии на продуктивность.
Код, который компилируется, — не значит код, который работает
В benchmark EmbedAgent от июня 2025 года DeepSeek-R1 достиг лишь 55% pass@1 на 126 embedded-задачах; кроссплатформенное портирование уронило результат до 29% на ESP-IDF. Ещё показательнее: Claude-3.7-Thinking тратил 78% своих reasoning-токенов не на планирование, а на исправление собственного багованного кода — эффект overthinking. Статья 2026 года в Future Internet протестировала 27 LLM на полном IoT-стеке (датчик → InfluxDB → Grafana); почти все выдали firmware, которое компилировалось, но было аппаратно неверным. Несовпадение версий библиотек, неверные битовые поля регистров, выдуманные формулы для датчиков.
У embedded-мира есть особенность: баги живут далеко. В веб-приложении баг лечится обновлением страницы; в firmware баг превращает в «кирпичи» десять тысяч устройств в поле. Анализ GitClear по 211 миллионам строк кода показывает: дублирование кода выросло на 48% с 2020 по 2024 год; в репозиториях с интенсивным использованием AI накопленный refactor-долг на 34% выше. Для IoT-команд это не роскошь, а реальная проблема — память ограничена, батарея ограничена, OTA-обновления дороги. Раздутый код означает меньшее время работы от батареи, а значит — отзыв устройств у клиентов. В опросе Stack Overflow 2025 года доля «активно не доверяю AI» выросла с 31% до 46%.
Какую дверь вы охраняете, а какую открываете?
Правы обе стороны — при разных условиях. Вот гипотеза, которая вытекает из пересечения пяти исследований: LLM дают сильный прирост в IoT на ограниченных, проверяемых, одноразовых задачах. Написать парсер протокола, сгенерировать функцию калибровки датчика, собрать каркас регрессионного теста, набросать документацию. За пределами этой границы — системный дизайн, timing-критичные процедуры, интеграция нескольких компонентов, safety-критичные модули — возможности модели резко падают. Прирост даёт не сам инструмент, а инженерная дисциплина, выстроенная вокруг него. Как формулирует DORA: AI — это усилитель.
В следующий вторник Дженк сидит на втором полевом тесте. На этот раз команда проверяет каждую строку DMA, написанную LLM, на осциллографе. Два дополнительных часа работы — дешевле, чем недельный отзыв устройств из поля. Его дашборд по-прежнему открыт; цифры продуктивности растут — на этот раз медленнее, но устойчиво. В 2026 году настоящий вопрос для IoT-команд — не «использовать ли нам AI?». Настоящий вопрос такой: какую дверь вы охраняете, а какую открываете? Потому что то, что отделяет −19% от +26%, — это не модель, а дисциплина её использования.
Источники:
- METR arXiv:2507.09089
- Cui et al. Microsoft/MIT RCT
- EmbedAgent arXiv:2506.11003
- MDPI Future Internet 18(2):94
- Englhardt CHI EA 2024
- GitClear Code Quality Report 2025
- DORA 2025
- Stack Overflow Developer Survey 2025
- Khare et al. arXiv:2509.19708.