

La dashboard di Cenk: il paradosso dell'AI nel mondo embedded
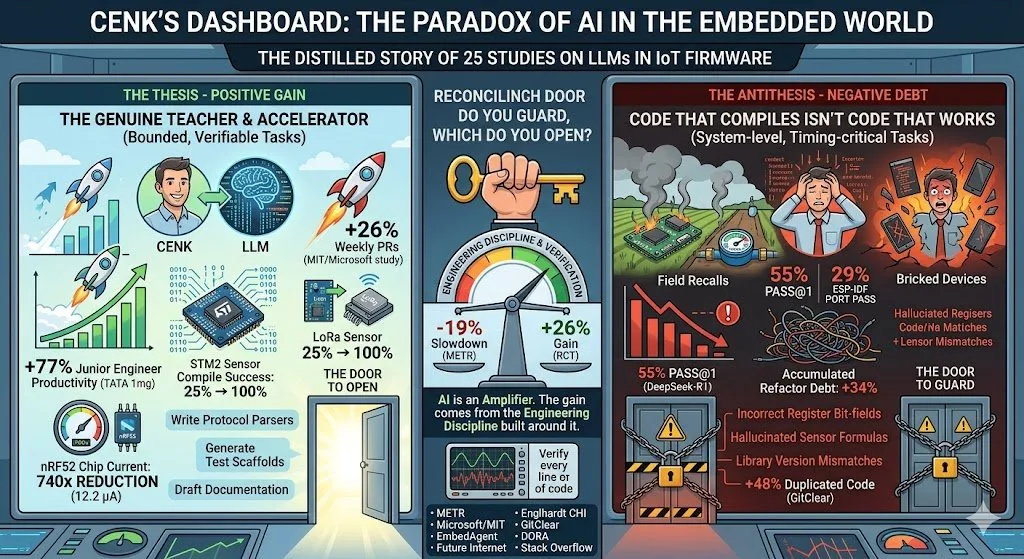
La storia distillata di 25 studi.
Martedì mattina, 9:14. In una piccola startup IoT di Ankara, Cenk, un firmware engineer senior, fissa lo schermo. Deve configurare il campionamento ADC basato su DMA su una scheda STM32. Chiede a Claude — il codice arriva, compila, viene flashato. I sensori producono dati. Cenk sorride. La settimana successiva, dodici contatori d’acqua smart sul campo iniziano a bloccarsi in modo casuale. Il colpevole: una configurazione errata del clock di una periferica. Il compilatore non poteva accorgersene; il silicio sì. Cenk guarda la sua dashboard e si chiede: questo strumento ci sta davvero velocizzando, o ci sta solo facendo sentire veloci?
Cenk non è solo. Due degli studi più eclatanti del 2025 si contraddicono apertamente. Nell’esperimento controllato di METR, 16 sviluppatori open source esperti hanno impiegato il 19% di tempo in più a completare i task usando strumenti di AI — avevano previsto un’accelerazione del 24%, e dopo erano ancora convinti di essere stati il 20% più veloci. Nello stesso anno, un RCT congiunto di Microsoft, MIT e Princeton con 4.867 sviluppatori ha misurato un aumento del 26% delle PR settimanali. Due studi, due direzioni opposte. Quale dei due prevale nel mondo dei sistemi embedded?
Lo strumento insegna, accelera, democratizza — davvero
Le evidenze sono solide. Nello studio di Englhardt al CHI 2024, il workflow uomo–AI ha portato il tasso di successo nella compilazione di sensori LoRa dal 25% al 100% — persino utenti senza alcuna esperienza hardware sono riusciti a costruire sensori funzionanti. Nello stesso studio, GPT-4 ha ridotto l’assorbimento di corrente del chip nRF52 di un fattore 740× grazie a un’ottimizzazione dei consumi specifica per il contesto — fino a 12,2 microampere. Nello studio durato un anno di TATA 1mg su 300 ingegneri, gli sviluppatori junior hanno registrato aumenti di produttività fino al 77%. Secondo DORA 2025, il 90% degli sviluppatori usa ormai l’AI; l’80% riporta effetti positivi sulla produttività.
Codice che compila non è codice che funziona
Nel benchmark EmbedAgent del giugno 2025, DeepSeek-R1 ha raggiunto solo il 55% di pass@1 su 126 task embedded; il porting cross-platform è sceso al 29% su ESP-IDF. Ancora più significativo: Claude-3.7-Thinking ha speso il 78% dei suoi token di ragionamento non per pianificare, ma per correggere il proprio codice buggato — l’effetto overthinking. Un paper del 2026 su Future Internet ha testato 27 LLM su uno stack IoT completo (sensore → InfluxDB → Grafana); quasi tutti hanno prodotto firmware che compilava ma era sbagliato per l’hardware. Versioni di librerie non corrispondenti, bit-field di registri errati, formule di sensori inventate.
Il mondo embedded ha una sua peculiarità: i bug vivono lontano. In una web app, un bug si risolve ricaricando la pagina; nel firmware, un bug può mandare in brick diecimila dispositivi sul campo. L’analisi di GitClear su 211 milioni di righe di codice mostra che il codice duplicato è cresciuto del 48% dal 2020 al 2024; nei repository con uso intensivo di AI, il debito di refactor accumulato è superiore del 34%. Per i team IoT non è un problema di lusso: la memoria è poca, la batteria è poca, gli aggiornamenti OTA sono costosi. Codice gonfiato significa minore durata della batteria, che significa richiami dai clienti. Nel sondaggio Stack Overflow 2025, la voce “diffido attivamente dell’AI” è balzata dal 31% al 46%.
Quale porta sorvegli, e quale apri?
Hanno ragione entrambi — a condizioni diverse. Ecco l’ipotesi che emerge dall’intersezione di cinque studi: gli LLM offrono guadagni consistenti nell’IoT su task delimitati, verificabili e usa-e-getta. Scrivere un parser di protocollo, generare una funzione di calibrazione di un sensore, preparare lo scaffold di un regression test, buttare giù documentazione. Fuori da quel perimetro — progettazione a livello di sistema, routine timing-critical, integrazione multi-componente, moduli safety-critical — la capacità crolla in modo drastico. Il guadagno non viene dallo strumento, ma dalla disciplina ingegneristica costruita intorno ad esso. Come dice DORA: l’AI è un amplificatore.
Cenk è seduto al secondo test sul campo il martedì successivo. Questa volta il team verifica all’oscilloscopio ogni riga DMA scritta dall’LLM. Due ore di lavoro in più, più economiche di una settimana di richiamo dal campo. La sua dashboard è ancora aperta; i numeri di produttività salgono — questa volta più lentamente, ma in modo duraturo. Nel 2026, la vera domanda per i team IoT non è “dobbiamo usare l’AI?”. La vera domanda è: quale porta sorvegli, e quale apri? Perché ciò che separa il −19% dal +26% non è il modello — è la disciplina nell’usarlo.
Fonti:
- METR arXiv:2507.09089
- Cui et al. Microsoft/MIT RCT
- EmbedAgent arXiv:2506.11003
- MDPI Future Internet 18(2):94
- Englhardt CHI EA 2024
- GitClear Code Quality Report 2025
- DORA 2025
- Stack Overflow Developer Survey 2025
- Khare et al. arXiv:2509.19708.