

لوحة Cenk: مفارقة الذكاء الاصطناعي في عالم الأنظمة المدمجة
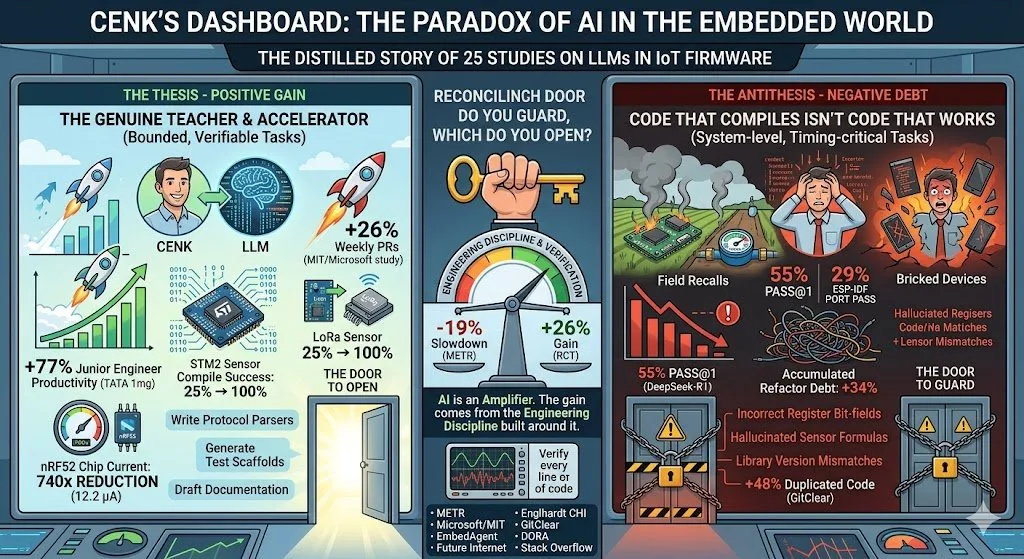
القصة المُقطرَّة لـ 25 دراسة.
صباح الثلاثاء، 9:14. في شركة IoT ناشئة صغيرة في أنقرة، يحدّق Cenk، مهندس firmware أول، في شاشته. عليه إعداد أخذ عيّنات ADC عبر DMA على لوحة STM32. يسأل Claude — فيصل الكود، يُترجم، ويُحمَّل على الشريحة. الحساسات تُنتج بيانات. يبتسم Cenk. في الأسبوع التالي، تبدأ اثنا عشر عداد مياه ذكياً في الميدان بالتجمّد بشكل عشوائي. الجاني: إعداد خاطئ لساعة إحدى الوحدات الطرفية. المُترجم لم يستطع كشفه؛ أما العتاد فكشفه. ينظر Cenk إلى لوحته ويسأل نفسه: هل هذه الأداة تُسرّعنا فعلاً، أم أنها تجعلنا نشعر بالسرعة فحسب؟
Cenk ليس وحيداً. فدراستان من أبرز دراسات 2025 تتناقضان علناً. في تجربة METR المضبوطة، استغرق 16 مطوّراً خبيراً في المصدر المفتوح وقتاً أطول بنسبة 19% لإنجاز المهام عند استخدام أدوات الذكاء الاصطناعي — وكانوا قد توقعوا مسبقاً تسريعاً بنسبة 24%، وبعدها ظلّوا يعتقدون أنهم كانوا أسرع بنسبة 20%. وفي العام نفسه، قيست تجربة RCT مشتركة من Microsoft وMIT وPrinceton على 4,867 مطوّراً زيادة بنسبة 26% في عدد PRs الأسبوعية. دراستان، واتجاهان متعاكسان. فأيهما يسود في عالم الأنظمة المدمجة؟
الأداة تُعلّم وتُسرّع وتفتح الباب للجميع
الأدلة قوية. في دراسة Englhardt في CHI 2024، رفع سير العمل المشترك بين الإنسان والذكاء الاصطناعي معدلات نجاح ترجمة حساسات LoRa من 25% إلى 100% — حتى إن مستخدمين بلا أي خبرة عتادية استطاعوا بناء حساسات عاملة. وفي الدراسة نفسها، خفّض GPT-4 سحب التيار في شريحة nRF52 بمعامل 740× عبر تحسين استهلاك الطاقة بحسب السياق — وصولاً إلى 12.2 ميكروأمبير. وفي دراسة TATA 1mg التي استمرت عاماً على 300 مهندس، حقق المطوّرون المبتدئون مكاسب إنتاجية تصل إلى 77%. وبحسب DORA 2025، يستخدم 90% من المطوّرين الذكاء الاصطناعي اليوم؛ ويُبلغ 80% عن آثار إيجابية على الإنتاجية.
الكود الذي يُترجم ليس بالضرورة كوداً يعمل
في benchmark EmbedAgent لشهر يونيو 2025، لم يحقق DeepSeek-R1 سوى 55% في pass@1 عبر 126 مهمة مدمجة؛ وهبط الرقم إلى 29% على ESP-IDF عند النقل بين المنصات. والأكثر لفتاً: أنفق Claude-3.7-Thinking نسبة 78% من رموز استدلاله (reasoning tokens) لا على التخطيط، بل على إصلاح أكواده المعطوبة التي كتبها بنفسه — إنه تأثير فرط التفكير. واختبرت ورقة بحثية في Future Internet عام 2026 عدد 27 نموذج LLM على stack كامل لـ IoT (حساس ← InfluxDB ← Grafana)؛ وأنتجت جميعها تقريباً firmware يُترجم بنجاح لكنه خاطئ عتادياً. عدم تطابق إصدارات المكتبات، وحقول بتات registers غير صحيحة، وصيغ حساسات مُهلوسة.
لعالم الأنظمة المدمجة خصوصية: الأخطاء تعيش بعيداً. في تطبيق ويب، الخطأ يُصلَح بتحديث الصفحة؛ أما في firmware، فالخطأ يعطّل عشرة آلاف جهاز في الميدان. ويُظهر تحليل GitClear لـ 211 مليون سطر من الكود أن الكود المكرر ارتفع بنسبة 48% بين 2020 و2024؛ وفي المستودعات الكثيفة الاستخدام للذكاء الاصطناعي، يزيد دَين إعادة الهيكلة المتراكم بنسبة 34%. بالنسبة لفرق IoT، هذه ليست مشكلة ترف — الذاكرة محدودة، والبطارية محدودة، وتحديثات OTA مكلفة. الكود المنتفخ يعني عمر بطارية أقصر، وهذا يعني استدعاء منتجات من العملاء. وفي استطلاع Stack Overflow 2025، قفزت نسبة من «ينتابهم عدم ثقة فعلي بالذكاء الاصطناعي» من 31% إلى 46%.
أي باب تحرس، وأي باب تفتح؟
كلا الطرفين محق — تحت شروط مختلفة. وإليك الفرضية التي تبرز من تقاطع خمس دراسات: تحقق نماذج LLM مكاسب قوية في IoT ضمن المهام المحدودة القابلة للتحقق والقابلة للرمي. اكتب parser لبروتوكول، أو ولّد دالة معايرة لحساس، أو أعدّ هيكل regression test، أو صِغ مسودة توثيق. خارج هذه الحدود — تصميم على مستوى النظام، وإجراءات حرجة زمنياً، وتكامل متعدد المكونات، ووحدات حرجة للسلامة — تنهار القدرة بشكل حاد. المكسب لا يأتي من الأداة نفسها بل من الانضباط الهندسي المبني حولها. وكما تصيغها DORA: الذكاء الاصطناعي مُضخِّم.
يجلس Cenk في الاختبار الميداني الثاني يوم الثلاثاء التالي. هذه المرة، يتحقق الفريق من كل سطر DMA كتبه LLM على oscilloscope. ساعتان إضافيتان من العمل، أرخص من استدعاء ميداني يدوم أسبوعاً. لوحته لا تزال مفتوحة؛ وأرقام الإنتاجية ترتفع — هذه المرة ببطء أكبر، لكن بثبات. في 2026، السؤال الحقيقي لفرق IoT ليس «هل نستخدم الذكاء الاصطناعي؟» بل: أي باب تحرس، وأي باب تفتح؟ لأن ما يفصل −19% عن +26% ليس النموذج — بل انضباط استخدامه.
المصادر:
- METR arXiv:2507.09089
- Cui et al. Microsoft/MIT RCT
- EmbedAgent arXiv:2506.11003
- MDPI Future Internet 18(2):94
- Englhardt CHI EA 2024
- GitClear Code Quality Report 2025
- DORA 2025
- Stack Overflow Developer Survey 2025
- Khare et al. arXiv:2509.19708.