

داشبورد جنک: پارادوکس AI در دنیای embedded
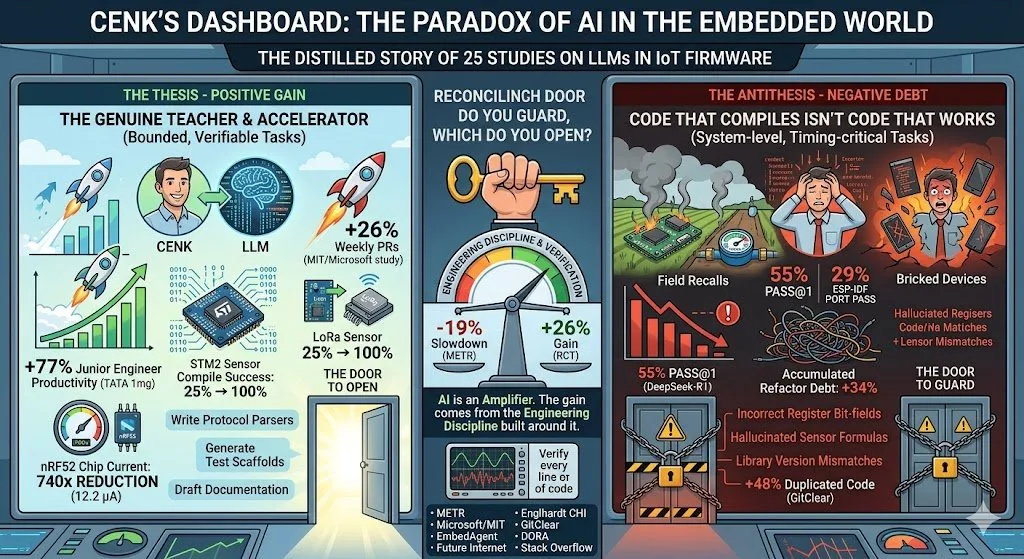
داستان چکیده 25 پژوهش.
سهشنبه صبح، ساعت 9:14. در یک استارتاپ کوچک IoT در آنکارا، جنک، مهندس ارشد firmware، به صفحهاش خیره شده است. باید نمونهبرداری ADC مبتنی بر DMA را روی یک برد STM32 راهاندازی کند. از Claude میپرسد — کد میرسد، کامپایل میشود، روی برد فلش میشود. سنسورها داده تولید میکنند. جنک لبخند میزند. هفته بعد، دوازده کنتور هوشمند آب در میدان بهطور تصادفی فریز میشوند. مقصر: یک پیکربندی اشتباه در کلاک پریفرال. کامپایلر نتوانسته بود آن را بگیرد؛ سیلیکون گرفت. جنک به داشبوردش نگاه میکند و از خودش میپرسد: آیا این ابزار واقعاً ما را سریعتر میکند، یا فقط حس سرعت را به ما میدهد؟
جنک تنها نیست. دو مورد از چشمگیرترین پژوهشهای 2025 آشکارا یکدیگر را نقض میکنند. در آزمایش کنترلشده METR، شانزده توسعهدهنده باتجربه open-source با استفاده از ابزارهای AI، 19٪ کندتر به تکمیل تسکها رسیدند — در حالی که پیش از آن 24٪ شتاب پیشبینی کرده بودند و بعد از آن هم هنوز باور داشتند 20٪ سریعتر شدهاند. همان سال، یک RCT مشترک از Microsoft، MIT و Princeton با 4,867 توسعهدهنده، افزایش 26٪ در PRهای هفتگی را اندازه گرفت. دو پژوهش، دو جهت مخالف. کدام یک در دنیای سیستمهای embedded غلبه دارد؟
ابزار واقعاً آموزش میدهد، شتاب میدهد، دموکراتیک میکند
شواهد قوی است. در پژوهش Englhardt در CHI 2024، گردشکار انسان–AI نرخ موفقیت کامپایل سنسورهای LoRa را از 25٪ به 100٪ رساند — حتی کاربرانی با تجربه صفر در سختافزار توانستند سنسورهای کارکنان بسازند. در همان پژوهش، GPT-4 با بهینهسازی توانِ حساس به بستر، جریان مصرفی چیپ nRF52 را به اندازه 740 برابر کاهش داد — تا 12.2 میکروآمپر. در پژوهش یکساله TATA 1mg روی 300 مهندس، توسعهدهندگان junior تا 77٪ افزایش بهرهوری دیدند. طبق DORA 2025، 90٪ توسعهدهندگان اکنون از AI استفاده میکنند؛ 80٪ اثرات مثبت بر بهرهوری گزارش میدهند.
کدی که کامپایل میشود، لزوماً کدی نیست که کار میکند
در benchmark EmbedAgent در ژوئن 2025، DeepSeek-R1 در 126 تسک embedded تنها به 55٪ pass@1 رسید؛ در porting بینپلتفرمی، این عدد روی ESP-IDF به 29٪ افت کرد. حتی گویاتر: 78٪ توکنهای استدلالی Claude-3.7-Thinking صرف برنامهریزی نشد، بلکه صرف اصلاح کد باگدار خودش شد — اثر overthinking. یک مقاله 2026 در Future Internet، 27 مدل LLM را روی یک stack کامل IoT (سنسور → InfluxDB → Grafana) آزمایش کرد؛ تقریباً همه firmwareهایی تولید کردند که کامپایل میشدند اما از نظر سختافزاری اشتباه بودند. ناسازگاری نسخه کتابخانهها، bit-fieldهای رجیستر نادرست، فرمولهای سنسور توهمزده.
دنیای embedded یک ویژگی خاص دارد: باگها دور از دسترس زندگی میکنند. در یک اپلیکیشن وب، باگ با رفرش صفحه برطرف میشود؛ در firmware، یک باگ دههزار دستگاه در میدان را brick میکند. تحلیل GitClear روی 211 میلیون خط کد نشان میدهد کد تکراری از 2020 تا 2024 به میزان 48٪ افزایش یافته است؛ در ریپوهای پراستفاده از AI، بدهی refactor انباشته 34٪ بیشتر است. برای تیمهای IoT، این یک مسئله لوکس نیست — حافظه تنگ است، باتری تنگ است، بهروزرسانیهای OTA گراناند. کد متورم یعنی عمر باتری کوتاهتر یعنی فراخوان محصول. در نظرسنجی Stack Overflow 2025، «بیاعتمادی فعال به AI» از 31٪ به 46٪ جهش کرد.
کدام در را نگهبانی میدهید و کدام را باز میکنید؟
هر دو طرف درست میگویند — تحت شرایط متفاوت. این فرضیهای است که از تقاطع پنج پژوهش بیرون میآید: LLMها در IoT روی تسکهای محدود، قابل راستیآزمایی و یکبارمصرف، بهرههای قوی میدهند. یک protocol parser بنویسید، یک تابع کالیبراسیون سنسور تولید کنید، اسکلت یک regression test بسازید، پیشنویس مستندات بگیرید. بیرون از آن مرز — طراحی در سطح سیستم، روتینهای timing-critical، یکپارچهسازی چندکامپوننته، ماژولهای safety-critical — توانایی بهطرز چشمگیری فرو میریزد. بهره نه از خود ابزار، بلکه از انضباط مهندسی است که دور آن ساخته میشود. همانطور که DORA میگوید: AI یک تقویتکننده است.
جنک سهشنبه بعد در دومین تست میدانی مینشیند. این بار، تیم هر خط DMA که LLM نوشته را روی اسیلوسکوپ راستیآزمایی میکند. دو ساعت کار اضافه، ارزانتر از یک هفته فراخوان میدانی. داشبوردش هنوز باز است؛ اعداد بهرهوری در حال بالا رفتناند — این بار کندتر، اما پایدار. در 2026، پرسش واقعی برای تیمهای IoT «آیا باید از AI استفاده کنیم؟» نیست. پرسش واقعی این است: کدام در را نگهبانی میدهید و کدام را باز میکنید؟ چون چیزی که −19٪ را از +26٪ جدا میکند مدل نیست — انضباطِ استفاده از آن است.
منابع:
- METR arXiv:2507.09089
- Cui et al. Microsoft/MIT RCT
- EmbedAgent arXiv:2506.11003
- MDPI Future Internet 18(2):94
- Englhardt CHI EA 2024
- GitClear Code Quality Report 2025
- DORA 2025
- Stack Overflow Developer Survey 2025
- Khare et al. arXiv:2509.19708.