

El panel de Cenk: la paradoja de la IA en el mundo embedded
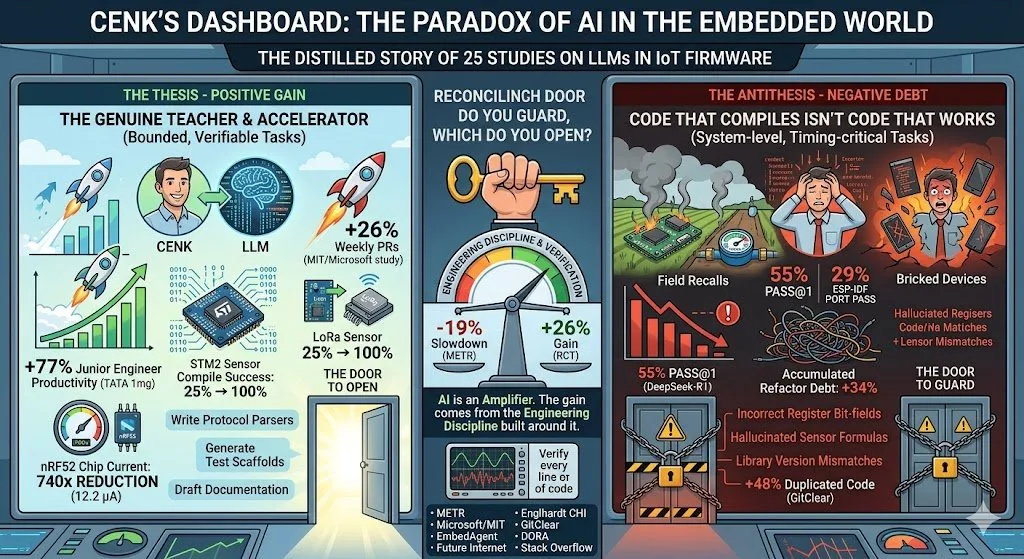
La historia destilada de 25 estudios.
Martes por la mañana, 9:14. En una pequeña startup de IoT en Ankara, Cenk, un ingeniero senior de firmware, mira fijamente su pantalla. Necesita configurar el muestreo ADC por DMA en una placa STM32. Se lo pide a Claude: el código llega, compila, se graba. Los sensores producen datos. Cenk sonríe. La semana siguiente, doce contadores inteligentes de agua en campo empiezan a congelarse aleatoriamente. El culpable: una mala configuración del reloj de un periférico. El compilador no pudo detectarla; el silicio sí. Cenk mira su panel y se pregunta: ¿esta herramienta realmente nos está acelerando, o solo nos hace sentir rápidos?
Cenk no está solo. Dos de los estudios más llamativos de 2025 se contradicen abiertamente. En el experimento controlado de METR, 16 desarrolladores experimentados de open source tardaron un 19% más en completar sus tareas usando herramientas de IA; de antemano habían previsto una aceleración del 24%, y después seguían creyendo que habían sido un 20% más rápidos. Ese mismo año, un RCT conjunto de Microsoft, MIT y Princeton con 4.867 desarrolladores midió un aumento del 26% en los PR semanales. Dos estudios, dos direcciones opuestas. ¿Cuál domina en el mundo de los sistemas embedded?
La herramienta realmente enseña, acelera, democratiza
La evidencia es sólida. En el estudio de Englhardt en CHI 2024, el flujo de trabajo humano–IA elevó la tasa de compilación exitosa de sensores LoRa del 25% al 100%: incluso usuarios sin ninguna experiencia en hardware pudieron construir sensores funcionales. En el mismo estudio, GPT-4 redujo el consumo de corriente del chip nRF52 por un factor de 740× mediante optimización de potencia específica del contexto, hasta 12,2 microamperios. En el estudio de un año de TATA 1mg con 300 ingenieros, los desarrolladores junior vieron ganancias de productividad de hasta el 77%. Según DORA 2025, el 90% de los desarrolladores ya usa IA; el 80% reporta efectos positivos sobre la productividad.
El código que compila no es código que funciona
En el benchmark EmbedAgent de junio de 2025, DeepSeek-R1 logró solo un 55% de pass@1 en 126 tareas embedded; el porting multiplataforma lo bajó al 29% en ESP-IDF. Más llamativo aún: Claude-3.7-Thinking gastó el 78% de sus tokens de razonamiento no en planificar, sino en corregir su propio código defectuoso: el efecto overthinking. Un artículo de 2026 en Future Internet probó 27 LLMs sobre un stack IoT completo (sensor → InfluxDB → Grafana); casi todos produjeron firmware que compilaba pero era incorrecto para el hardware. Incompatibilidades de versiones de bibliotecas, campos de bits de registros incorrectos, fórmulas de sensores alucinadas.
El mundo embedded tiene una peculiaridad: los bugs viven lejos. En una aplicación web, un bug se arregla recargando la página; en firmware, un bug bloquea diez mil dispositivos en campo. El análisis de GitClear sobre 211 millones de líneas de código muestra que el código duplicado creció un 48% entre 2020 y 2024; en los repositorios con mucha IA, la deuda de refactorización acumulada es un 34% mayor. Para los equipos de IoT esto no es un problema de lujo: la memoria es escasa, la batería es escasa, las actualizaciones OTA son caras. Código hinchado significa menos duración de batería, significa retiradas de producto. En la encuesta de Stack Overflow de 2025, los que «desconfían activamente de la IA» saltaron del 31% al 46%.
¿Qué puerta vigilas y cuál abres?
Ambos lados tienen razón, bajo condiciones distintas. Esta es la hipótesis que surge de la intersección de cinco estudios: los LLMs ofrecen ganancias sólidas en IoT en tareas acotadas, verificables y desechables. Escribir un parser de protocolo, generar una función de calibración de sensores, montar el esqueleto de una prueba de regresión, redactar documentación. Fuera de ese límite (diseño a nivel de sistema, rutinas críticas en tiempo, integración de múltiples componentes, módulos de seguridad crítica) la capacidad se desploma. La ganancia no viene de la herramienta, sino de la disciplina de ingeniería construida a su alrededor. Como dice DORA: la IA es un amplificador.
Cenk se sienta en la segunda prueba de campo el martes siguiente. Esta vez, el equipo verifica cada línea de DMA que escribió el LLM con un osciloscopio. Dos horas extra de trabajo, más baratas que una semana de retirada en campo. Su panel sigue abierto; los números de productividad suben, esta vez más despacio, pero de forma duradera. En 2026, la verdadera pregunta para los equipos de IoT no es «¿debemos usar IA?». La verdadera pregunta es: ¿qué puerta vigilas y cuál abres? Porque lo que separa el −19% del +26% no es el modelo: es la disciplina con que se usa.
Fuentes:
- METR arXiv:2507.09089
- Cui et al. RCT Microsoft/MIT
- EmbedAgent arXiv:2506.11003
- MDPI Future Internet 18(2):94
- Englhardt CHI EA 2024
- GitClear Code Quality Report 2025
- DORA 2025
- Stack Overflow Developer Survey 2025
- Khare et al. arXiv:2509.19708.