

Playbook end-to-end per lo sviluppo di prodotti IoT – Fase 6: Verifica e validazione – Abbiamo costruito la cosa giusta (e funziona davvero)?
Introduzione alla fase di V&V
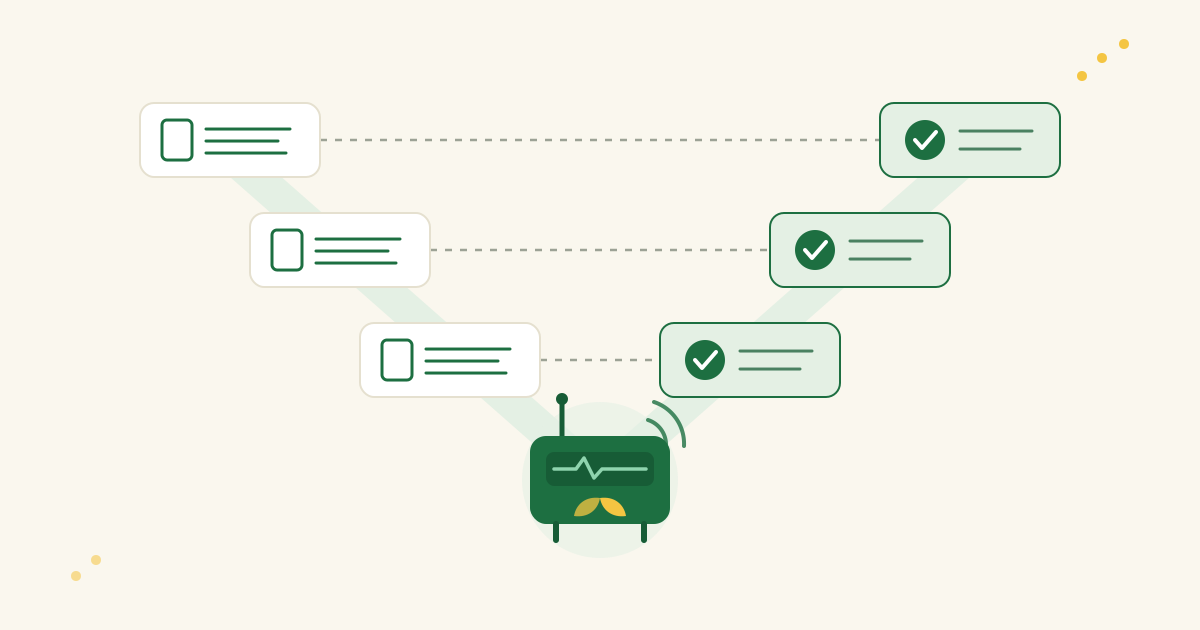
Verifica e validazione (V&V) è l’ultimo gate prima che un prodotto IoT venga spedito, e risponde a due domande ingannevolmente semplici. La verifica chiede: “Abbiamo costruito la cosa nel modo giusto?” — il prodotto soddisfa i requisiti specificati? La validazione chiede: “Abbiamo costruito la cosa giusta?” — il prodotto soddisfa davvero i bisogni degli utenti nel mondo reale? Le due sono complementari: una vi mantiene onesti verso la specifica, l’altra vi mantiene onesti verso il cliente.
Dal punto di vista temporale, la V&V entra in gioco dopo l’integrazione e dopo il design freeze. Ormai avete dimostrato che hardware e software riescono a parlarsi; avete finito di aggiungere funzionalità; e siete pronti a mettere l’intero stack sotto i riflettori. Pensate a questa fase come all’esame finale: ogni affermazione fatta nelle fasi precedenti viene testata, ufficialmente. L’obiettivo è l’evidenza — risultati di test ripetibili, tracciabili ai requisiti e agli scenari utente — che vi permette di spedire con fiducia anziché con le dita incrociate (IEEE, 2017; NASA, 2016).
Livelli di testing: un percorso a ostacoli multi-livello
Un prodotto IoT è uno stack: hardware (sensori, alimentazione, radio), firmware (logica embedded) e cloud/app (API, database, dashboard). Verifichiamo ogni livello per i suoi meriti, poi validiamo il sistema end-to-end contro le user story. Ogni livello deve superare l’esame per conto suo prima che lo stack venga giudicato nel suo insieme.
Verifica hardware: torture test per il vostro gadget
Test funzionale con fixture (test jig). Prima, dimostrate che il dispositivo assemblato fa ciò che lo schematico ha promesso. Una fixture bed-of-nails o una jig a pogo pin rende rapido l’esercizio dei GPIO, la lettura dei sensori con stimoli noti, il flash del firmware e la verifica delle rail di alimentazione. Automatizzatela così ogni scheda riceve lo stesso interrogatorio imparziale. State costruendo lo stesso muscolo che vi servirà per i test di produzione end-of-line più avanti; il vostro futuro team di produzione vi ringrazierà (NASA, 2016).
Test di stress e affidabilità (HALT). Poi, la palestra — e oltre. La HALT (Highly Accelerated Life Test) spinge temperatura, vibrazione e stress elettrico ben oltre le normali condizioni operative per far emergere gli anelli deboli prima che lo facciano i vostri clienti (Hobbs, 2008; Thermotron, n.d.; Accendo Reliability, n.d.). Il punto non è tanto “superare” quanto scoprire: imparare dove il design cede, correggere la causa radice e costruire margine. Se il vostro dispositivo è classificato 0–50 °C, volete sapere come si comporta a −20 o +70 così che il mondo reale sembri facile.
Pre-scansioni normative (EMC/ESD). Le certificazioni formali (emissioni/immunità EMC, ESD, radio, sicurezza) possono silurare le tempistiche se scoprite i problemi in laboratorio. Fate controlli di pre-compliance ora: misurate le emissioni irradiate/condotte in un setup basilare, colpite il dispositivo con scariche ESD e sondando le linee rumorose. Scansioni precoci e iterative riducono sia il rischio sia l’over-engineering (Tektronix, n.d.; Interference Technology, 2017; Keysight, n.d.). Se sentite un fischio RF inatteso, potete ancora aggiungere filtri, ritoccare i duty cycle del firmware o aggiustare i percorsi di ritorno del PCB — al costo del prototipo, non al costo della produzione.
Benchmark rispetto alle specifiche. Infine, controllate il patto che avete fatto con voi stessi. Se avete promesso un’accuratezza di ±0,5 °C, dimostratela in camera contro un riferimento calibrato. Se avete promesso un anno di durata della batteria, misurate la corrente in tutte le modalità e proiettate realisticamente (includendo retry, aggiornamenti OTA e scenari “ops, il Wi-Fi è instabile”). La verifica a questo livello è la ricevuta dei vostri requisiti della Fase 1 (NASA, 2016).
Testing del firmware: codice sotto il microscopio
Unit test. Gli “atomi” del firmware sono funzioni e moduli; gli unit test danno loro una coscienza. Usate un test runner basato su host o un framework consapevole dell’MCU per validare calcoli, state machine e condizioni al contorno. Puntate a un’alta coverage — ma ricordate: la coverage trova codice non testato; non dimostra che i test siano buoni. Una policy come “~80%+ di branch coverage” è pragmatica; inseguire il 100% spesso produce rendimenti decrescenti e test fragili.
Integration test sul dispositivo. Mettete insieme driver, task RTOS e stack di comunicazione ed esercitateli su hardware reale. Fornite una tensione nota a un ADC e controllate il valore riportato; pubblicate un payload sintetico e verificate il flusso di ACK del dispositivo; togliete e ridate alimentazione a metà trasferimento e confermate il recupero corretto. Automatizzate ciò che potete così ogni build del firmware affronta lo stesso percorso a ostacoli imparziale (NASA, 2016).
Static analysis e standard di codifica. Gli strumenti che leggono il codice senza eseguirlo intercettano intere classi di bug (buffer overflow, dereferenziazioni di null, race hazard) e fanno rispettare le regole (per esempio i sottoinsiemi MISRA-C). Nella Fase 6, portate i problemi critici a zero e giustificate eventuali deroghe. È un’assicurazione economica per dispositivi che devono funzionare incustoditi per mesi (IEEE, 2017).
Fuzz e stress. Siate un “utente malvagio”. Fate fuzz degli input al confine UART/USB/MQTT, fate cadere e ripristinare le reti ripetutamente, fate traboccare le code e fate girare per giorni per stanare leak e blocchi. Se distribuite OTA, simulate connettività cattiva, batteria scarica e reset a metà aggiornamento; assicuratevi che il rollback funzioni. L’obiettivo non è fare bella figura — è forzare stati rari e dimostrare che il firmware fallisce in sicurezza e si riprende in modo prevedibile.
Testing di cloud/API e UX: l’altra metà del puzzle
Test API automatizzati. Ogni interfaccia pubblica — REST, topic MQTT, endpoint WebSocket — merita test eseguibili per i percorsi felici e i casi limite strani (payload invalidi, token scaduti, campi mancanti). Integrateli nella CI; se il contratto di un endpoint deriva, lo scoprirete prima dei clienti.
Security testing (OWASP). Applicate il pensiero dell’OWASP Top 10 alla vostra web app e l’OWASP API Security Top 10 (2023) alle API di dispositivo e app: broken access control, difetti di autenticazione, design insicuro e misconfigurazione sono cattivi perenniali. Scansionate, fate pentest e correggete sistematicamente; trattate le vulnerabilità critiche come bloccanti per il lancio.
Load testing e prova di scala. Se vi aspettate 1.000 dispositivi al picco, simulatene 2.000; testate raffiche di connessioni dopo un outage; variate dimensioni dei messaggi, QoS e cipher TLS. I broker MQTT e i backend spesso si comportano diversamente su scala; meglio scoprire ora la fame di code e le partizioni calde.
Test UX. Date la UI mobile/web a occhi freschi. Un utente alla prima esperienza riesce a fare l’onboarding di un dispositivo senza conoscenza tribale? I grafici sono accurati e le unità coerenti? L’alert dice cosa è successo, dove e cosa fare dopo? Alla validazione non importa che il database sia normalizzato; importa che l’utente sorrida e riesca.
Validazione di sistema: end-to-end, per davvero
È qui che smettiamo di testare pezzi e iniziamo a testare storie: il termostato che tiene calda l’officina, il sensore della catena del freddo che manda un messaggio quando un frigo si scalda, il rilevatore di perdite che chiama l’idraulico (beh, invia un alert). La validazione chiede: la soluzione, nel suo insieme, svolge il lavoro per cui è stata assunta?
Esecuzioni di scenari end-to-end. Prendete ogni user story dalla Fase 1 ed eseguitela per davvero. “Come facility manager, ricevo un alert entro 60 secondi se la temperatura del congelatore > −10 °C, e posso vedere un grafico delle 24 ore.” Portate il dispositivo al caldo, verificate l’ingestion nel cloud, confermate la consegna dell’alert e osservate la UI. Ripetete attraverso reti, fusi orari e stati del dispositivo.
Requirements Traceability Matrix (RTM). Ora, mostrate l’evidenza. Una RTM mappa ogni “deve” a uno o più artefatti di verifica (test case, analisi, ispezione) così che nulla sia dimenticato e nulla di extra si intrufoli. Ecco uno schizzo in testo semplice:
- R1: “Il dispositivo deve connettersi al Wi-Fi entro 30 s.” → Test TC-10 “Wi-Fi timing” → Superato
- R2: “Il sistema deve archiviare le letture orarie del sensore per 12 mesi.” → Test TC-21 (retention), TC-22 (query) → Superato
- R3: “L’app deve mostrare il valore corrente del sensore entro ±1 °C dal riferimento.” → Test TC-30 (camera), TC-31 (formato UI) → Fallito (bug di arrotondamento nella UI; correzione tracciata)
La RTM vi dà una mappa di copertura a colpo d’occhio dal requisito alla prova, che auditor, valutatori di sicurezza e il vostro io futuro ameranno.
Beta trial (validazione sul campo). Il successo in laboratorio è necessario ma non sufficiente. Mettete i dispositivi in ambienti reali con utenti reali per qualche settimana. Imparerete cose che il vostro laboratorio non può replicare: configurazioni Wi-Fi strane, comportamenti umani creativi, ambienti a −15 °C, o la sorprendente luminosità di un LED in una camera da letto buia. Beta chiusa o aperta, raccogliete feedback strutturato e log di crash/telemetria. Date priorità ai risultati che bloccano il setup, la fiducia nei dati o il valore principale.
Criteri di superamento/fallimento e severità. Decidete in anticipo come uscirete dalla Fase 6. Un’asticella comune è 0 problemi aperti di Severity-1, tutti i requisiti verificati e obiettivi di prestazione raggiunti. Framework di severità come IEEE 1044-2009 vi aiutano a mantenere oggettive le discussioni sull’impatto dei bug: Sev-1 = showstopper/insicuro/inutilizzabile; Sev-2 = funzione importante compromessa; Sev-3 = minore/ha workaround; Sev-4 = cosmetico (IEEE, 2009). Usatelo per guidare il triage e il go/no-go a mente lucida.
Consigli pratici e pensieri finali
Celebrate i successi; imparate dai fallimenti. Una scheda temprata dalla HALT, un fuzz del firmware che gira per 72 ore senza crash, una suite di test API tutta verde — sono mini-vittorie. Per i fallimenti, siate grati di averli trovati qui; il bug più economico è quello che correggete prima che i clienti lo incontrino.
Tenete l’utente nel circuito. È facile “vincere in laboratorio” ma perdere in salotto. Il feedback della beta su confusione nel setup, alert rumorosi o unità non corrispondenti produce spesso piccole modifiche con un impatto smisurato sulla qualità percepita.
Trattate la V&V come un investimento. Le prove di pre-compliance e di scala sembrano lavoro extra — finché non risparmiano un mese in certificazione o impediscono al vostro giorno di lancio di afflosciarsi sotto una tempesta di dispositivi a sorpresa.
Documentate da professionisti. Archiviate piani di test, risultati ed evidenze della RTM. Quando tornerete per la Fase 7 (conformità e trasferimento alla produzione), o per la v2.0 l’anno prossimo, sarete felici di aver lasciato una scia di briciole.
La coverage è una torcia, non un trofeo. Usate la coverage per trovare gli angoli bui; non presentatela come unica metrica di qualità. Portafogli bilanciati — unit, integration, end-to-end e property-based/fuzz — battono qualsiasi singolo numero.
Quando potete dire con fiducia “Sì, abbiamo costruito la cosa nel modo giusto” e “Sì, abbiamo costruito la cosa giusta”, avete superato l’ultimo gate. Avanti verso certificazione e lancio — con meno sorprese, evidenze più solide e un prodotto che il team è orgoglioso di spedire.