

Playbook de desarrollo de productos IoT de extremo a extremo - Etapa 6: Verificación y validación – ¿Construimos lo correcto (y funciona de verdad)?
Introducción a la fase de V&V
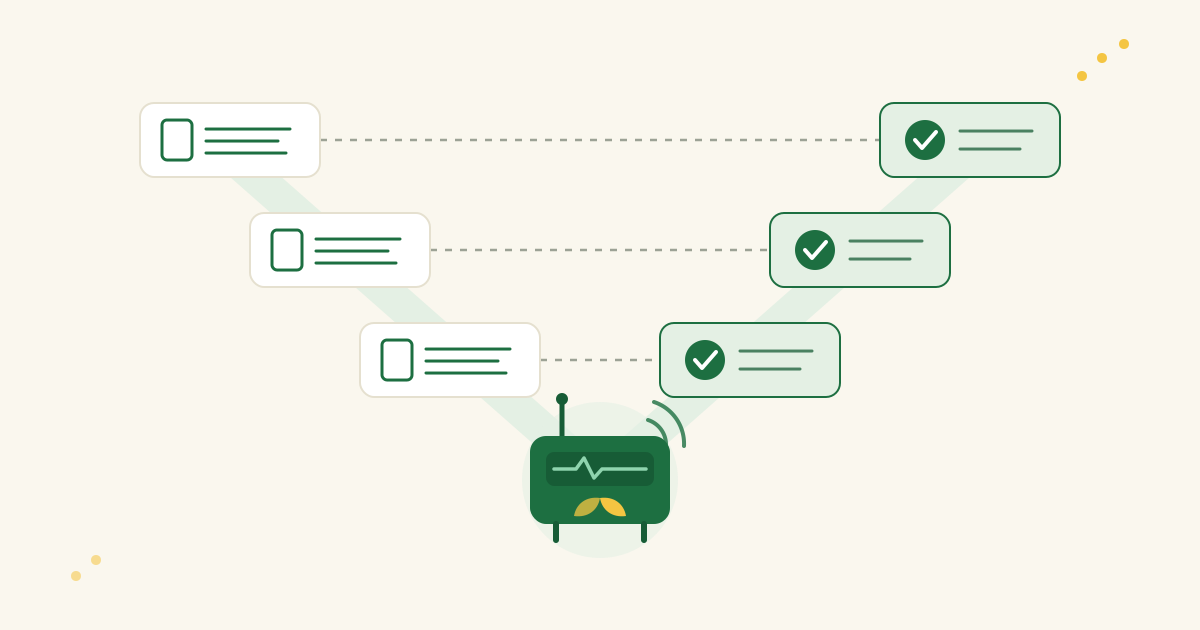
La verificación y validación (V&V) es la última puerta antes de que un producto IoT se envíe, y responde a dos preguntas engañosamente simples. La verificación pregunta: «¿Construimos la cosa correctamente?»: ¿cumple el producto sus requisitos especificados? La validación pregunta: «¿Construimos la cosa correcta?»: ¿cumple el producto realmente las necesidades del usuario en el mundo real? Las dos son complementarias: una te mantiene honesto con la especificación, la otra te mantiene honesto con el cliente.
En cuanto a la temporización, la V&V entra en juego tras la integración y tras la congelación del diseño. A estas alturas, has demostrado que el hardware y el software pueden hablarse; has terminado de añadir funciones; y estás listo para poner todo el stack bajo los focos. Piensa en esta fase como el examen final: cada afirmación hecha en las etapas anteriores se pone a prueba, oficialmente. El objetivo es evidencia: resultados de pruebas repetibles, trazables a los requisitos y a los escenarios de usuario, que te permiten lanzar con confianza en lugar de con los dedos cruzados (IEEE, 2017; NASA, 2016).
Capas de pruebas: una carrera de obstáculos multicapa
Un producto IoT es un stack: hardware (sensores, alimentación, radio), firmware (lógica embebida) y cloud/app (APIs, bases de datos, dashboards). Verificamos cada capa por sus propios méritos y luego validamos el sistema de extremo a extremo contra las user stories. Cada capa tiene que aprobar por sí sola antes de que el stack se juzgue como un todo.
Verificación de hardware: pruebas de tortura para tu gadget
Pruebas funcionales con fixtures (test jigs). Primero, demuestra que el dispositivo ensamblado hace lo que el esquemático prometió. Un fixture bed-of-nails o un jig de pogo pins hace un trabajo rápido ejercitando GPIOs, leyendo sensores con estímulos conocidos, grabando firmware y verificando los raíles de alimentación. Automatízalo para que cada placa reciba el mismo interrogatorio imparcial. Estás construyendo el mismo músculo que necesitarás para las pruebas de fin de línea de producción después; tu futuro equipo de fabricación te lo agradecerá (NASA, 2016).
Pruebas de estrés y fiabilidad (HALT). A continuación, el gimnasio, y algo más. HALT (Highly Accelerated Life Test) eleva la temperatura, la vibración y el estrés eléctrico mucho más allá de las condiciones normales de operación para sacar a la luz los eslabones débiles antes de que lo hagan tus clientes (Hobbs, 2008; Thermotron, n.d.; Accendo Reliability, n.d.). El punto no es tanto «aprobar» como descubrir: aprender dónde se agrieta el diseño, arreglar la causa raíz y construir margen. Si tu dispositivo está clasificado para 0–50 °C, quieres saber cómo se comporta a −20 o +70 para que el mundo real parezca fácil.
Pre-scans regulatorios (EMC/ESD). Las certificaciones formales (emisiones/inmunidad EMC, ESD, radio, seguridad) pueden torpedear los calendarios si descubres los problemas en el laboratorio. Haz comprobaciones de pre-cumplimiento ahora: mide las emisiones radiadas/conducidas en un montaje básico, descarga ESD sobre el dispositivo y sondea las líneas ruidosas. Los escaneos tempranos e iterativos reducen tanto el riesgo como la sobre-ingeniería (Tektronix, n.d.; Interference Technology, 2017; Keysight, n.d.). Si oyes un chirrido de RF inesperado, aún puedes añadir filtros, retocar los duty cycles del firmware o ajustar los caminos de retorno de la PCB: a coste de prototipo, no a coste de producción.
Benchmark frente a especificaciones. Por último, comprueba el trato que hiciste contigo mismo. Si prometiste una precisión de ±0,5 °C, demuéstrala en una cámara contra una referencia calibrada. Si prometiste un año de duración de batería, mide la corriente en todos los modos y proyecta de forma realista (incluyendo reintentos, actualizaciones OTA y escenarios de «ups, el Wi-Fi está flojo»). La verificación a este nivel es el recibo de tus requisitos de la Etapa 1 (NASA, 2016).
Pruebas de firmware: código bajo el microscopio
Pruebas unitarias. Los «átomos» del firmware son las funciones y los módulos; las pruebas unitarias les dan una conciencia. Usa un test runner basado en host o un framework consciente del MCU para validar cálculos, máquinas de estados y condiciones límite. Aspira a una cobertura alta, pero recuerda: la cobertura encuentra código sin probar; no demuestra que las pruebas sean buenas. Una política como «~80%+ de cobertura de ramas» es pragmática; perseguir el 100% a menudo produce rendimientos decrecientes y pruebas frágiles.
Pruebas de integración en el dispositivo. Junta drivers, tareas del RTOS y stacks de comunicaciones y ejercítalos sobre hardware real. Alimenta un voltaje conocido a un ADC y comprueba el valor reportado; publica un payload sintético y verifica el flujo de ACK del dispositivo; corta la alimentación a mitad de una transferencia y confirma la recuperación correcta. Automatiza lo que puedas para que cada build de firmware se enfrente a la misma carrera de obstáculos imparcial (NASA, 2016).
Análisis estático y estándares de codificación. Las herramientas que leen el código sin ejecutarlo cazan clases enteras de bugs (buffer overflows, desreferencias nulas, riesgos de carrera) e imponen reglas (p. ej., subconjuntos de MISRA-C). En la Etapa 6, lleva los problemas críticos a cero y justifica cualquier excepción. Es un seguro barato para dispositivos que deben funcionar desatendidos durante meses (IEEE, 2017).
Fuzz y estrés. Sé un «usuario malvado». Haz fuzzing de las entradas en la frontera UART/USB/MQTT, corta y restaura las redes repetidamente, desborda las colas y ejecuta durante días para sacar a la luz fugas y bloqueos. Si distribuyes OTA, simula mala conectividad, batería baja y reinicios a mitad de actualización; asegúrate de que el rollback funciona. El objetivo no es presumir: es forzar estados raros y demostrar que el firmware falla de forma segura y se recupera de forma predecible.
Pruebas de cloud/API y UX: la otra mitad del puzle
Pruebas automatizadas de API. Cada interfaz pública —REST, topics de MQTT, endpoints de WebSocket— merece pruebas ejecutables para los caminos felices y los bordes raros (payloads inválidos, tokens expirados, campos ausentes). Intégralas en CI; si el contrato de un endpoint deriva, te enterarás antes que los clientes.
Pruebas de seguridad (OWASP). Aplica el pensamiento del OWASP Top 10 a tu aplicación web y el OWASP API Security Top 10 (2023) a las APIs de tu dispositivo y tu app: control de acceso roto, fallos de autenticación, diseño inseguro y mala configuración son villanos perennes. Escanea, haz pentesting y corrige sistemáticamente; trata las vulnerabilidades críticas como bloqueantes del lanzamiento.
Pruebas de carga y ensayo de escala. Si esperas 1.000 dispositivos en el pico, simula 2.000; prueba ráfagas de conexión tras una caída; varía los tamaños de mensaje, el QoS y los ciphers TLS. Los brokers MQTT y los backends a menudo se comportan de forma diferente a escala; mejor descubrir la inanición de colas y las particiones calientes ahora.
Pruebas de UX. Entrega la UI móvil/web a ojos frescos. ¿Puede un usuario primerizo dar de alta un dispositivo sin conocimiento tribal? ¿Las gráficas son precisas y las unidades consistentes? ¿La alerta dice qué pasó, dónde y qué hacer a continuación? A la validación no le importa que la base de datos esté normalizada; le importa que el usuario sonría y tenga éxito.
Validación del sistema: de extremo a extremo, de verdad
Aquí es donde dejamos de probar piezas y empezamos a probar historias: el termostato que mantiene caliente el taller, el sensor de cadena de frío que manda un mensaje cuando una nevera se calienta, el detector de fugas que llama a un fontanero (bueno, envía una alerta). La validación pregunta: ¿la solución, como un todo, cumple el trabajo para el que fue contratada?
Ejecuciones de escenarios de extremo a extremo. Toma cada user story de la Etapa 1 y ejecútala de verdad. «Como responsable de instalaciones, recibo una alerta en 60 segundos si la temperatura del congelador > −10 °C, y puedo ver una gráfica de 24 horas». Lleva el dispositivo a calor, verifica la ingesta en la nube, confirma la entrega de la alerta y observa la UI. Repite a través de redes, zonas horarias y estados del dispositivo.
Matriz de trazabilidad de requisitos (RTM). Ahora, muestra la evidencia. Una RTM mapea cada «deberá» a uno o más artefactos de verificación (caso de prueba, análisis, inspección) para que nada se olvide y nada extra se cuele. Aquí va un boceto en texto plano:
- R1: «El dispositivo se conectará al Wi-Fi en 30 s.» → Prueba TC-10 «temporización Wi-Fi» → Aprobado
- R2: «El sistema almacenará lecturas de sensores cada hora durante 12 meses.» → Pruebas TC-21 (retención), TC-22 (consulta) → Aprobado
- R3: «La app mostrará el valor actual del sensor dentro de ±1 °C de la referencia.» → Pruebas TC-30 (cámara), TC-31 (formato UI) → Suspenso (bug de redondeo en la UI; corrección en seguimiento)
La RTM te da un mapa de cobertura de un vistazo, del requisito a la prueba, que los auditores, los evaluadores de seguridad y tu yo futuro adorarán.
Pruebas beta (validación en campo). El éxito en el laboratorio es necesario pero no suficiente. Pon dispositivos en entornos reales con usuarios reales durante unas semanas. Aprenderás cosas que tu laboratorio no puede replicar: configuraciones de Wi-Fi raras, comportamientos humanos creativos, entornos a −15 °C, o el sorprendente brillo de un LED en un dormitorio a oscuras. Beta cerrada o beta abierta, recoge feedback estructurado y logs de fallos/telemetría. Prioriza los hallazgos que bloquean la configuración, la confianza en los datos o el valor central.
Criterios de aprobado/suspenso y severidad. Decide por adelantado cómo saldrás de la Etapa 6. Un listón común es 0 problemas de Severity-1 abiertos, todos los requisitos verificados y objetivos de rendimiento cumplidos. Los frameworks de severidad como IEEE 1044-2009 te ayudan a mantener objetivas las discusiones sobre el impacto de los bugs: Sev-1 = showstopper/inseguro/inutilizable; Sev-2 = función mayor perjudicada; Sev-3 = menor/tiene workaround; Sev-4 = cosmético (IEEE, 2009). Úsalo para dirigir el triage y el go/no-go con la cabeza despejada.
Consejos prácticos y reflexiones finales
Celebra los aprobados; aprende de los suspensos. Una placa endurecida por HALT, un fuzz de firmware que corre 72 horas sin colgarse, una suite de pruebas de API toda en verde: esas son mini-victorias. De los fallos, agradece haberlos encontrado aquí; el bug más barato es el que arreglas antes de que los clientes lo conozcan.
Mantén al usuario en el bucle. Es fácil «ganar en el laboratorio» pero perder en el salón de casa. El feedback de la beta sobre confusión en la configuración, alertas ruidosas o unidades que no coinciden a menudo produce cambios pequeños con un impacto desproporcionado en la calidad percibida.
Trata la V&V como una inversión. El pre-cumplimiento y los ensayos de carga parecen trabajo extra, hasta que te ahorran un mes en certificación o evitan que tu día de lanzamiento se hunda bajo una tormenta sorpresa de dispositivos.
Documenta como un profesional. Archiva los planes de prueba, los resultados y la evidencia de la RTM. Cuando vuelvas para la Etapa 7 (cumplimiento y transferencia a fabricación), o para la v2.0 el año que viene, te alegrarás de haber dejado un rastro de migas de pan.
La cobertura es una linterna, no un trofeo. Usa la cobertura para encontrar rincones oscuros; no la enmarques como una única métrica de calidad. Las carteras equilibradas —unitarias, integración, extremo a extremo y basadas en propiedades/fuzz— le ganan a cualquier número único.
Cuando puedas decir con confianza «Sí, construimos la cosa correctamente» y «Sí, construimos la cosa correcta», has superado la última puerta. Adelante, a la certificación y el lanzamiento: con menos sorpresas, evidencia más sólida y un producto que el equipo está orgulloso de enviar.