

Playbook de développement de produit IoT de bout en bout – Étape 6 : Vérification & validation – Avons-nous construit la bonne chose (et fonctionne-t-elle vraiment) ?
Introduction à la phase V&V
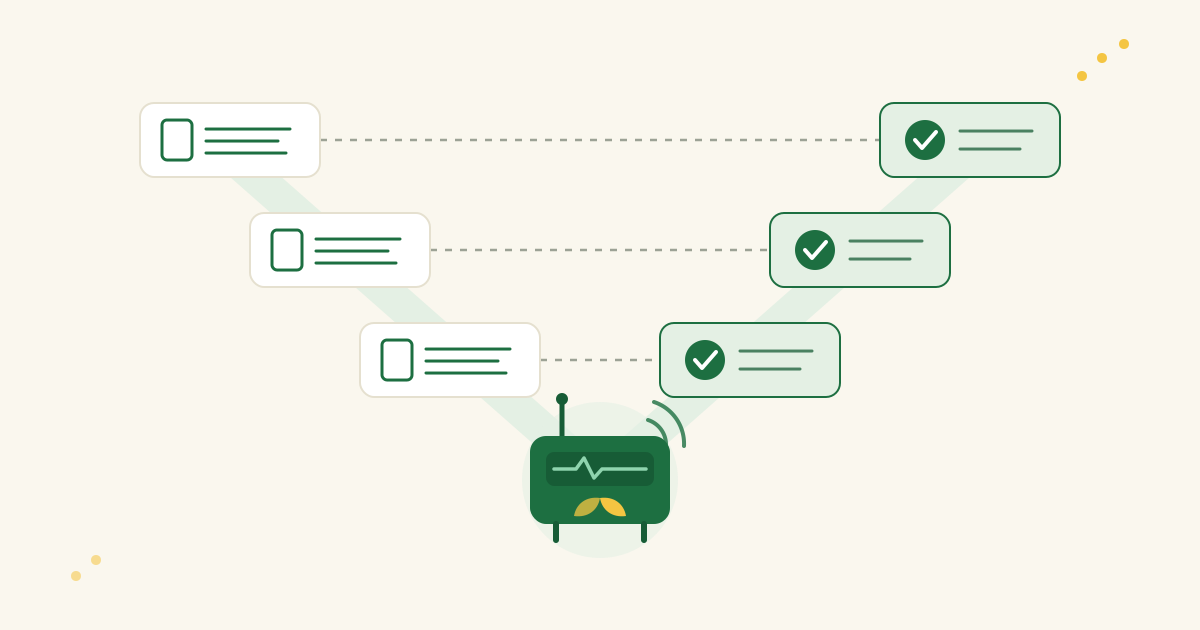
La Vérification & Validation (V&V) est la dernière porte avant qu’un produit IoT ne soit expédié, et elle répond à deux questions trompeusement simples. La vérification demande : « Avons-nous construit la chose correctement ? » — le produit répond-il à ses exigences spécifiées. La validation demande : « Avons-nous construit la bonne chose ? » — le produit répond-il réellement aux besoins des utilisateurs dans le monde réel. Les deux sont complémentaires : l’une vous maintient honnête envers la spec, l’autre vous maintient honnête envers le client.
Côté timing, la V&V entre en jeu après l’intégration et après le gel de conception. À ce stade, vous avez prouvé que le matériel et le logiciel peuvent se parler ; vous avez fini d’ajouter des fonctionnalités ; et vous êtes prêt à mettre toute la stack sous les projecteurs. Voyez cette phase comme l’examen final : chaque affirmation faite dans les étapes précédentes est testée, officiellement. L’objectif est la preuve — des résultats de test reproductibles, traçables jusqu’aux exigences et aux scénarios utilisateur — qui vous permet d’expédier avec confiance plutôt qu’avec les doigts croisés (IEEE, 2017 ; NASA, 2016).
Couches de tests : un parcours du combattant multi-couches
Un produit IoT est une stack : matériel (capteurs, alimentation, radio), firmware (logique embarquée), et cloud/app (APIs, bases de données, tableaux de bord). Nous vérifions chaque couche pour ses propres mérites, puis validons le système de bout en bout contre les user stories. Chaque couche doit passer pour elle-même avant que la stack soit jugée dans son ensemble.
Vérification matérielle : tests de torture pour votre gadget
Tests fonctionnels avec fixtures (test jigs). D’abord, prouvez que l’appareil assemblé fait ce que le schéma a promis. Une fixture bed-of-nails ou un gabarit à pogo pins fait rapidement le travail d’exercer les GPIOs, lire les capteurs avec des stimuli connus, flasher le firmware, et vérifier les rails d’alimentation. Automatisez-le pour que chaque carte subisse le même interrogatoire impartial. Vous construisez le même muscle dont vous aurez besoin pour les tests de fin de ligne en production plus tard ; votre future équipe de fabrication vous remerciera (NASA, 2016).
Tests de stress et de fiabilité (HALT). Ensuite, la salle de sport — et plus encore. Le HALT (Highly Accelerated Life Test) pousse la température, les vibrations et le stress électrique bien au-delà des conditions normales de fonctionnement pour faire remonter les maillons faibles avant que vos clients ne le fassent (Hobbs, 2008 ; Thermotron, n.d. ; Accendo Reliability, n.d.). L’enjeu n’est pas tant de « passer » que de découvrir : apprendre où la conception craque, corriger la cause racine, et construire de la marge. Si votre appareil est évalué pour 0–50 °C, vous voulez savoir comment il se comporte à −20 ou +70 pour que le monde réel semble facile.
Pre-scans réglementaires (EMC/ESD). Les certifications formelles (émissions/immunité EMC, ESD, radio, sécurité) peuvent torpiller les plannings si vous découvrez des problèmes au laboratoire. Faites des contrôles de pré-conformité maintenant : mesurez les émissions rayonnées/conduites dans un montage basique, zappez l’appareil avec des décharges ESD, et sondez les lignes bruyantes. Des scans précoces et itératifs réduisent à la fois le risque et le sur-engineering (Tektronix, n.d. ; Interference Technology, 2017 ; Keysight, n.d.). Si vous entendez un couinement RF inattendu, vous pouvez encore ajouter des filtres, ajuster les duty cycles du firmware, ou régler les chemins de retour du PCB — au coût d’un prototype, pas d’une production.
Benchmark vs specs. Enfin, vérifiez le marché que vous avez passé avec vous-même. Si vous avez promis une précision de ±0,5 °C, prouvez-la en chambre contre une référence étalonnée. Si vous avez promis un an d’autonomie de batterie, mesurez le courant dans tous les modes et projetez de façon réaliste (en incluant les retries, les mises à jour OTA, et les scénarios « oups, le Wi-Fi est capricieux »). La vérification à ce niveau est le reçu de vos exigences de l’Étape 1 (NASA, 2016).
Tests firmware : le code sous le microscope
Tests unitaires. Les « atomes » du firmware sont les fonctions et les modules ; les tests unitaires leur donnent une conscience. Utilisez un test runner sur machine hôte ou un framework adapté au MCU pour valider les calculs, les machines à états et les conditions limites. Visez une couverture élevée — mais rappelez-vous : la couverture trouve le code non testé ; elle ne prouve pas que les tests sont bons. Une politique du type « ~80 %+ de couverture de branches » est pragmatique ; courir après les 100 % donne souvent des rendements décroissants et des tests fragiles.
Tests d’intégration sur l’appareil. Assemblez drivers, tâches RTOS et stacks de communication, et exercez-les sur le matériel réel. Alimentez une tension connue à un ADC et vérifiez la valeur rapportée ; publiez un payload synthétique et vérifiez le flux d’ACK de l’appareil ; coupez l’alimentation au milieu d’un transfert et confirmez la reprise correcte. Automatisez ce que vous pouvez pour que chaque build de firmware affronte le même parcours impartial (NASA, 2016).
Analyse statique et standards de codage. Les outils qui lisent le code sans l’exécuter attrapent des classes entières de bugs (débordements de buffer, déréférencements nuls, risques de race conditions) et font respecter des règles (p. ex. les sous-ensembles MISRA-C). À l’Étape 6, ramenez les problèmes critiques à zéro et justifiez toute dérogation. C’est une assurance bon marché pour des appareils qui doivent tourner sans surveillance pendant des mois (IEEE, 2017).
Fuzzing et stress. Soyez un « utilisateur malveillant ». Fuzzez les entrées à la frontière UART/USB/MQTT, coupez et restaurez les réseaux à répétition, faites déborder les files, et faites tourner pendant des jours pour fumer les fuites et les blocages. Si vous expédiez l’OTA, simulez une mauvaise connectivité, une batterie faible, et des resets en pleine mise à jour ; assurez-vous que le rollback fonctionne. Le but n’est pas d’impressionner — c’est de forcer les états rares et de prouver que le firmware échoue en sécurité et récupère de façon prévisible.
Tests cloud/API et UX : l’autre moitié du puzzle
Tests d’API automatisés. Chaque interface publique — REST, topics MQTT, endpoints WebSocket — mérite des tests exécutables pour les chemins heureux et les cas limites bizarres (payloads invalides, tokens expirés, champs manquants). Intégrez-les à la CI ; si le contrat d’un endpoint dérive, vous le saurez avant vos clients.
Tests de sécurité (OWASP). Appliquez la pensée OWASP Top 10 à votre application web et l’OWASP API Security Top 10 (2023) aux APIs de votre appareil et de votre application : broken access control, failles d’authentification, conception non sécurisée et mauvaise configuration sont des vilains éternels. Scannez, pentestez, et corrigez systématiquement ; traitez les vulnérabilités critiques comme des bloqueurs de lancement.
Tests de charge et répétition de passage à l’échelle. Si vous attendez 1 000 appareils au pic, simulez-en 2 000 ; testez les rafales de connexions après une panne ; variez les tailles de messages, les QoS et les chiffrements TLS. Les brokers MQTT et les backends se comportent souvent différemment à l’échelle ; mieux vaut découvrir la famine de files et les partitions chaudes maintenant.
Tests UX. Confiez l’UI mobile/web à des yeux frais. Un utilisateur débutant peut-il onboarder un appareil sans connaissance tribale ? Les graphiques sont-ils exacts et les unités cohérentes ? L’alerte dit-elle ce qui s’est passé, où, et que faire ensuite ? La validation se fiche que la base de données soit normalisée ; elle veut que l’utilisateur sourie et réussisse.
Validation système : de bout en bout, pour de vrai
C’est ici que nous arrêtons de tester des pièces et commençons à tester des histoires : le thermostat qui garde l’atelier au chaud, le capteur de chaîne du froid qui envoie un texto quand un frigo se réchauffe, le détecteur de fuite qui convoque un plombier (enfin, envoie une alerte). La validation demande : la solution, dans son ensemble, remplit-elle le travail pour lequel elle a été embauchée ?
Exécutions de scénarios de bout en bout. Prenez chaque user story de l’Étape 1 et exécutez-la pour de vrai. « En tant que responsable d’installations, je reçois une alerte en moins de 60 secondes si la température du congélateur > −10 °C, et je peux voir un graphique sur 24 heures. » Faites chauffer l’appareil, vérifiez l’ingestion cloud, confirmez la livraison de l’alerte, et observez l’UI. Répétez à travers réseaux, fuseaux horaires et états de l’appareil.
Matrice de traçabilité des exigences (RTM). Maintenant, montrez les preuves. Une RTM mappe chaque « doit » à un ou plusieurs artefacts de vérification (cas de test, analyse, inspection) pour que rien ne soit oublié et que rien de superflu ne se glisse. Voici une esquisse en texte brut :
- R1 : « L’appareil doit se connecter au Wi-Fi en moins de 30 s. » → Test TC-10 « timing Wi-Fi » → Réussi
- R2 : « Le système doit stocker les lectures horaires des capteurs pendant 12 mois. » → Tests TC-21 (rétention), TC-22 (requête) → Réussi
- R3 : « L’application doit afficher la valeur actuelle du capteur à ±1 °C de la référence. » → Tests TC-30 (chambre), TC-31 (format UI) → Échoué (bug d’arrondi UI ; correction suivie)
La RTM vous donne une carte de couverture en un coup d’œil, de l’exigence à la preuve, que les auditeurs, les évaluateurs de sécurité et votre futur vous-même adoreront.
Essais bêta (validation terrain). Le succès en labo est nécessaire mais pas suffisant. Mettez des appareils dans des environnements réels avec de vrais utilisateurs pendant quelques semaines. Vous apprendrez des choses que votre labo ne peut pas répliquer : des configurations Wi-Fi bizarres, des comportements humains créatifs, des environnements à −15 °C, ou la luminosité surprenante d’une LED dans une chambre noire. Bêta fermée ou ouverte, collectez du feedback structuré et des logs de crash/télémétrie. Priorisez les découvertes qui bloquent la configuration, la confiance dans les données, ou la valeur cœur.
Critères de réussite/échec et sévérité. Décidez dès le départ comment vous sortirez de l’Étape 6. Une barre courante est 0 problème de Sévérité 1 ouvert, toutes les exigences vérifiées, et objectifs de performance atteints. Les frameworks de sévérité comme l’IEEE 1044-2009 vous aident à garder les discussions d’impact des bugs objectives : Sev-1 = blocage/dangereux/inutilisable ; Sev-2 = fonction majeure altérée ; Sev-3 = mineur/a un contournement ; Sev-4 = cosmétique (IEEE, 2009). Utilisez-le pour piloter le triage et le go/no-go avec la tête froide.
Conseils pratiques et réflexions finales
Célébrez les réussites ; apprenez des échecs. Une carte endurcie au HALT, un fuzz firmware qui tourne 72 heures sans crash, une suite de tests d’API toute verte — ce sont des mini-victoires. Pour les échecs, soyez reconnaissant de les avoir trouvés ici ; le bug le moins cher est celui que vous corrigez avant que les clients ne le rencontrent.
Gardez l’utilisateur dans la boucle. Il est facile de « gagner le labo » mais de perdre le salon. Le feedback bêta sur la confusion de configuration, les alertes bruyantes, ou les unités incohérentes donne souvent de petits changements avec un impact démesuré sur la qualité perçue.
Traitez la V&V comme un investissement. La pré-conformité et les répétitions de charge semblent être du travail en plus — jusqu’à ce qu’elles économisent un mois de certification ou empêchent votre jour de lancement de s’affaisser sous une tempête d’appareils surprise.
Documentez comme un pro. Archivez plans de test, résultats et preuves RTM. Quand vous reviendrez pour l’Étape 7 (conformité et transfert de fabrication), ou pour la v2.0 l’année prochaine, vous serez content d’avoir laissé une piste de miettes de pain.
La couverture est une lampe torche, pas un trophée. Utilisez la couverture pour trouver les coins sombres ; ne l’érigez pas en métrique unique de qualité. Des portefeuilles équilibrés — tests unitaires, intégration, bout en bout, et property-based/fuzz — battent n’importe quel chiffre unique.
Quand vous pouvez dire avec confiance « Oui, nous avons construit la chose correctement » et « Oui, nous avons construit la bonne chose », vous avez franchi la dernière porte. En avant vers la certification et le lancement — avec moins de surprises, des preuves plus solides, et un produit que l’équipe est fière d’expédier.