

Para Além do OCR: Como os LLMs Estão a Transformar a Extração Estruturada de PDFs
Introdução
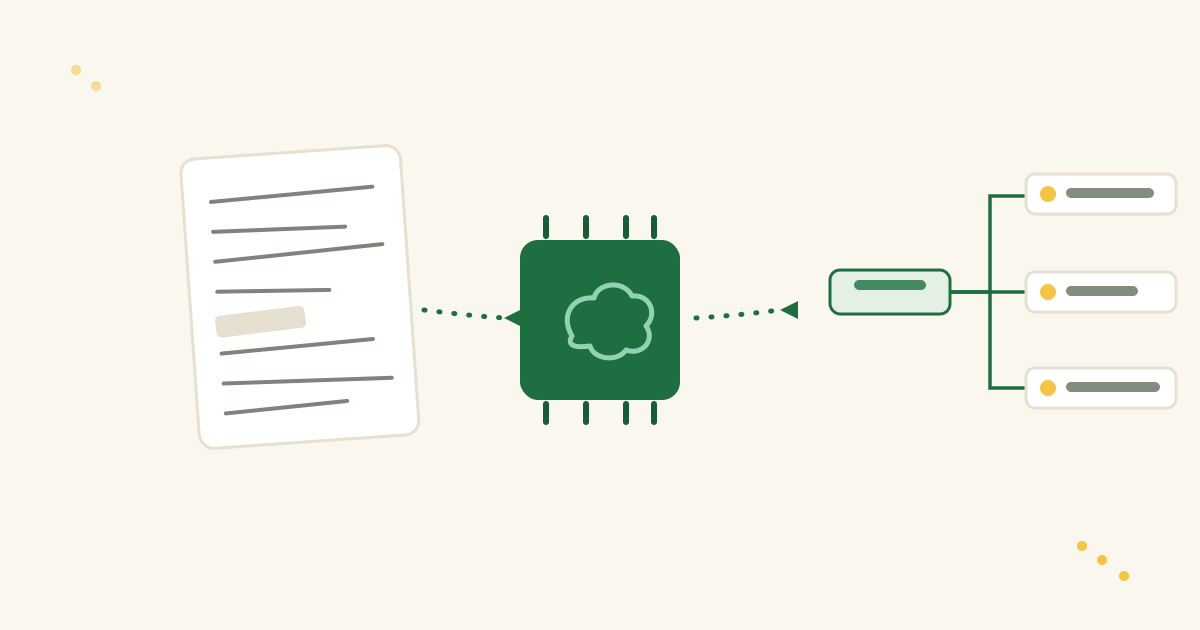
Os LLMs conseguem extrair dados estruturados de PDFs que os pipelines tradicionais de OCR tratam mal — sobretudo formulários complexos com campos de várias linhas e tabelas sem margens. Para perceber porquê, ajuda comparar como cada abordagem realmente lê um documento. Considere uma Declaração Aduaneira preenchida com descrições de artigos, quantidades e valores — capturar estes detalhes com precisão é crucial para a conformidade e o processamento a jusante. Tradicionalmente, as organizações confiaram no Optical Character Recognition (OCR) para digitalizar estes formulários. Avanços recentes em inteligência artificial, em particular os Large Language Models (LLMs), oferecem uma abordagem diferente: ler PDFs diretamente, preservando a sua estrutura. Este artigo compara o parsing tradicional baseado em OCR com a leitura direta de PDFs baseada em LLMs e analisa onde cada um se encaixa.
Como o OCR Tradicional Faz o Parsing de PDFs
Fluxo de Trabalho OCR: O software tradicional de OCR converte páginas digitalizadas ou conteúdo PDF em texto. O motor de OCR deteta caracteres e palavras numa imagem e produz uma transcrição em texto simples. Por exemplo, um OCR pode ler um formulário aduaneiro e produzir um bloco de texto com todas as palavras do formulário, linha a linha. As ferramentas modernas de OCR atingem elevada precisão em documentos limpos e dactilografados e têm sido, há muito, a forma padrão de digitalizar texto.
Limitações: O OCR “vê” apenas texto — não compreende o layout nem o contexto de um documento. Não sabe inerentemente que um texto é o nome de um cliente e outro é uma morada; reconhece-os como palavras isoladas na página. Como resultado, preservar as relações espaciais e a estrutura dos dados é difícil. Se o valor de um campo se estende por várias linhas (como um número de 12 dígitos partido em duas linhas), muitos sistemas de OCR tratam cada linha separadamente. Em tabelas sem margens, a ausência de separadores explícitos faz com que os limites das colunas se percam, produzindo resultados fundidos ou desalinhados. Para compensar, os fluxos de trabalho baseados em OCR dependem tipicamente de pós-processamento — dados posicionais e regras baseadas em modelos que reconstroem a estrutura original — o que se torna frágil quando os layouts variam.
Como os LLMs Leem PDFs de Forma Diferente
Fluxo de Trabalho LLM: Os Large Language Models abordam o problema a partir da compreensão da linguagem, e não do reconhecimento puro de padrões. Uma abordagem comum consiste em alimentar o texto extraído por OCR (com pistas de formatação) num LLM e pedir-lhe que extraia dados estruturados. Métodos mais avançados usam LLMs multimodais que recebem o documento em bruto (como imagem ou PDF), combinando análise visual e linguística. Em ambos os casos, o LLM não está apenas a transcrever caracteres; interpreta o documento tal como um humano faria, tendo em conta o contexto, o layout e o significado.
Compreensão de Contexto e Estrutura: Como os LLMs são treinados com grandes quantidades de texto e, em alguns casos, informação de layout, reconhecem formatos comuns e padrões de linguagem. Um LLM consegue inferir que uma sequência de palavras representa uma morada ou que uma lista de números forma uma coluna de tabela. Isto significa que consegue agrupar e rotular a informação numa única passagem, produzindo dados estruturados (como JSON) diretamente. Por exemplo, ao processar uma declaração aduaneira, um LLM pode produzir:
json
{
  "Total Value": 10000,
  "Currency": "USD",
  "ItemList": [
    { "Description": "Item A", "Quantity": 10, "Price": 50 },
    { "Description": "Item B", "Quantity": 5, "Price": 100 }
  ]
}
Os LLMs lidam bem com ambiguidade porque usam o contexto. Se a descrição de um artigo se estende por várias linhas, um LLM bem instruído compreende que a continuação pertence à entrada original e não a um novo artigo. Esta abordagem holística mantém a estrutura do documento intacta com muito menos intervenção manual.
Adaptação a Variações de Layout: Como os LLMs dependem de pistas contextuais e semânticas, adaptam-se melhor a variações de layout. Quer um formulário rotule um campo como “Total Value” ou “Grand Total”, um LLM consegue reconhecer a intenção por trás dos dados. Um único modelo pode assim lidar com vários tipos de formulários sem reprogramação — uma vantagem sobre sistemas rígidos de OCR baseados em regras.
Desafios do OCR com Documentos Complexos
Pontos problemáticos comuns do OCR em PDFs estruturados como formulários aduaneiros:
-
Perda de Contexto Espacial: O OCR produz um fluxo de texto sem indicadores claros das relações espaciais. Agrupamentos importantes — como que valor pertence a que campo — podem perder-se, exigindo lógica adicional para reconstituir os dados.
-
Tabelas Sem Margens ou Complexas: Muitos documentos empresariais usam espaçamento em vez de linhas de grelha desenhadas para definir tabelas. Os motores de OCR interpretam frequentemente mal estes layouts, partindo linhas de várias linhas em entradas separadas ou fundindo colunas adjacentes incorretamente.
-
Campos de Várias Linhas: Campos como moradas ou descrições de produtos que se estendem por várias linhas são outro desafio. O OCR tradicional pode tratar cada linha como uma entrada distinta, quebrando a continuidade dos dados.
-
Necessidades Extensas de Pós-Processamento: Extrair dados estruturados do resultado bruto do OCR exige frequentemente regras personalizadas, correspondência de padrões e heurísticas. Isto adiciona complexidade e exige manutenção contínua à medida que os formatos dos documentos evoluem.
Por Que os LLMs Funcionam Bem em Formulários Estruturados
O processamento baseado em LLMs responde a estes desafios incorporando compreensão contextual na etapa de extração:
-
Extração Contextual: Um LLM não vê apenas palavras — lê o seu significado. Ao interpretar o conteúdo como um todo, consegue associar valores aos respetivos campos, reduzindo a necessidade de pós-processamento.
-
Preservação da Estrutura: Com prompts adequados, os LLMs mantêm o agrupamento de dados relacionados. Por exemplo, os detalhes de cada linha de artigo numa declaração aduaneira permanecem associados, garantindo que rótulos e valores ficam corretamente emparelhados.
-
Gestão de Variações de Layout: Os LLMs são menos sensíveis a variações no formato do documento. A sua flexibilidade permite-lhes extrair a informação correta mesmo quando o layout muda de um documento para outro.
-
Menos Regras Manuais: Em vez de escrever e manter uma miríade de scripts personalizados para cada tipo de documento, os programadores podem confiar num prompt bem elaborado para guiar o LLM. Esta simplificação reduz o esforço de desenvolvimento e acelera a implementação.
A investigação em compreensão de documentos baseada em transformers mostra que combinar texto e informação de layout melhora o desempenho da extração. Modelos concebidos especificamente para processamento de documentos têm melhor desempenho em dados complexos, de várias linhas e em tabelas sem margens.
Comparando Precisão, Velocidade e Eficiência
Precisão: A extração baseada em LLMs tende a entregar maior precisão em documentos complexos. Os sistemas de OCR de última geração atingem elevada precisão em texto limpo, mas deixam uma margem de erro maior na extração de dados estruturados. Ao usar o contexto, os LLMs reduzem estes erros em aplicações do mundo real.
Velocidade: O OCR tradicional está otimizado para extração de texto em bruto e consegue processar dezenas de páginas por segundo. Os métodos baseados em LLMs são computacionalmente mais pesados e mais lentos por página, mas entregam dados estruturados diretamente — eliminando a maior parte do pós-processamento. Para muitos fluxos de trabalho empresariais, alguns segundos extra por documento são um preço pequeno pelos ganhos em precisão e automação.
Eficiência e Escalabilidade: O OCR é menos intensivo em recursos, o que o torna económico para implementações em grande escala. Os LLMs exigem mais computação, mas podem melhorar a eficiência operacional global ao reduzir correções manuais e regras de parsing personalizadas. A sua adaptabilidade a novos formatos de documentos sem reprogramação traduz-se também em poupanças de longo prazo em tempo e esforço de desenvolvimento.
Impacto Real nos Fluxos de Trabalho Empresariais
Para profissionais de negócio, cientistas de dados e programadores, a diferença entre OCR e extração baseada em LLMs não é apenas técnica — manifesta-se na eficiência operacional e na qualidade dos dados. Uma grande autoridade aduaneira que adotou um sistema de processamento de documentos orientado por LLMs reportou processamento de formulários mais rápido e uma redução clara de erros. Automatizar a extração permitiu-lhes processar formulários mais rapidamente, reduzir problemas de conformidade e libertar pessoal para tarefas mais complexas.
Maior precisão dos dados significa também menos erros a jusante, menos intervenção manual e acesso mais rápido a dados fiáveis para a tomada de decisões. Onde informação atempada e precisa importa, esses ganhos acumulam-se numa vantagem competitiva.
Conclusão e Pontos-Chave
Passar do OCR tradicional para a leitura de PDFs baseada em LLMs é um passo prático em frente no processamento de documentos. Pontos-chave:
-
Abordagens Diferentes: O OCR tradicional é eficaz na extração básica de texto, mas tem dificuldades com contexto e layout, enquanto os LLMs leem o texto dentro do seu contexto mais amplo, preservando relações e integridade dos dados.
-
Integridade dos Dados Estruturados: Em aplicações como Declarações Aduaneiras, manter os dados multi-campo estruturados é crítico. Os LLMs mantêm os elementos de dados relacionados corretamente emparelhados, o que melhora a precisão global.
-
Compromissos de Desempenho: O OCR oferece velocidade e baixo custo computacional; os LLMs fornecem resultados mais ricos e precisos que muitas vezes justificam o tempo de processamento extra. A compreensão de documentos baseada em transformers continua a reduzir os erros de extração.
-
Impacto nos Fluxos de Trabalho: Ao automatizar a extração de documentos complexos, os sistemas baseados em LLMs simplificam as operações, reduzem correções manuais e proporcionam acesso mais rápido e fiável a dados críticos.
Em resumo, o OCR tradicional continua a ser uma ferramenta útil para extração simples de texto, mas os LLMs estão a revelar-se mais eficazes para dados estruturados em documentos complexos. Para organizações que trabalham com formatos de documentos diversos e intricados, o processamento baseado em LLMs é a opção mais capaz e de manutenção mais fácil.