

Más allá del OCR: cómo los LLMs están transformando la extracción estructurada de PDF
Introducción
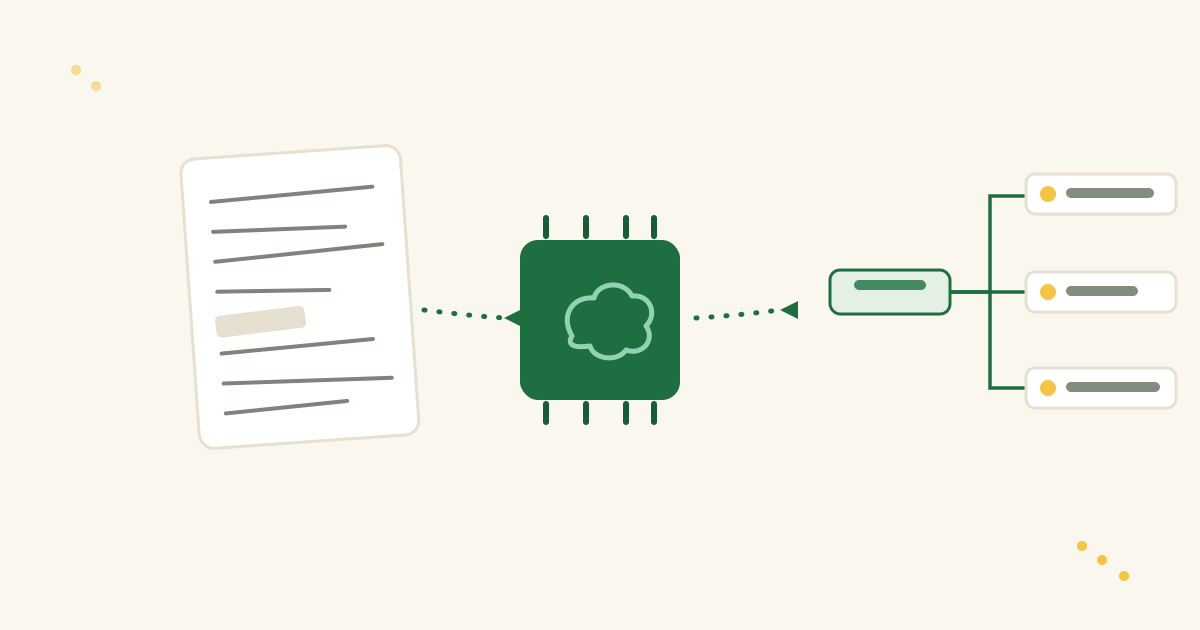
Los LLMs pueden extraer datos estructurados de PDF que los pipelines tradicionales de OCR manejan mal, sobre todo formularios complejos con campos multilínea y tablas sin bordes. Para entender por qué, conviene comparar cómo lee realmente un documento cada enfoque. Piensa en un formulario de declaración de aduanas lleno de descripciones de artículos, cantidades y valores: capturar estos datos con precisión es crucial para el cumplimiento normativo y el procesamiento posterior. Tradicionalmente, las organizaciones han recurrido al reconocimiento óptico de caracteres (OCR) para digitalizar este tipo de formularios. Los avances recientes en inteligencia artificial, en particular los modelos de lenguaje de gran escala (LLMs), ofrecen un enfoque distinto: leer los PDF directamente conservando su estructura. Este artículo compara el parseo tradicional basado en OCR con la lectura directa de PDF mediante LLMs, y analiza dónde encaja cada uno.
Cómo parsea los PDF el OCR tradicional
Flujo de trabajo del OCR: el software de OCR tradicional convierte páginas escaneadas o contenido PDF en texto. El motor de OCR detecta caracteres y palabras en una imagen y produce una transcripción en texto plano. Por ejemplo, un OCR puede leer un formulario de aduanas y devolver un bloque de texto con todas las palabras del formulario línea a línea. Las herramientas modernas de OCR logran una precisión alta en documentos limpios y mecanografiados, y llevan mucho tiempo siendo la forma estándar de digitalizar texto.
Limitaciones: el OCR solo «ve» texto; no entiende el diseño ni el contexto del documento. No sabe de forma inherente que un fragmento de texto es el nombre de un cliente y otro es una dirección; los reconoce como palabras aisladas en la página. En consecuencia, conservar las relaciones espaciales y la estructura de los datos resulta difícil. Si el valor de un campo ocupa varias líneas (como un número de 12 dígitos partido en dos líneas), muchos sistemas de OCR tratan cada línea por separado. En las tablas sin bordes, la ausencia de separadores explícitos hace que los límites de columna se pierdan, produciendo salidas fusionadas o desalineadas. Para compensarlo, los flujos de trabajo basados en OCR suelen depender de postprocesamiento (datos posicionales y reglas basadas en plantillas que reconstruyen la estructura original), que se vuelve frágil cuando los diseños varían.
Cómo leen los PDF los LLMs de forma diferente
Flujo de trabajo del LLM: los modelos de lenguaje de gran escala abordan el problema desde la comprensión del lenguaje, no desde el mero reconocimiento de patrones. Un enfoque habitual es alimentar al LLM con el texto extraído por OCR (con pistas de formato) y pedirle que extraiga datos estructurados. Los métodos más avanzados usan LLMs multimodales que toman como entrada el documento en bruto (como imagen o PDF), combinando análisis visual y lingüístico. En ambos casos, el LLM no se limita a transcribir caracteres: interpreta el documento casi como lo haría una persona, teniendo en cuenta el contexto, el diseño y el significado.
Comprensión del contexto y la estructura: como los LLMs se entrenan con grandes cantidades de texto y, en algunos casos, con información de diseño, reconocen formatos comunes y patrones del lenguaje. Un LLM puede inferir que una secuencia de palabras representa una dirección o que una lista de números forma la columna de una tabla. Esto significa que puede agrupar y etiquetar la información en una sola pasada, devolviendo datos estructurados (como JSON) directamente. Por ejemplo, al procesar una declaración de aduanas, un LLM podría devolver:
json
{
  "Total Value": 10000,
  "Currency": "USD",
  "ItemList": [
    { "Description": "Item A", "Quantity": 10, "Price": 50 },
    { "Description": "Item B", "Quantity": 5, "Price": 100 }
  ]
}
Los LLMs manejan bien la ambigüedad porque usan el contexto. Si la descripción de un artículo ocupa varias líneas, un LLM con un buen prompt entiende que la continuación pertenece a la entrada original y no a un artículo nuevo. Este enfoque holístico mantiene intacta la estructura del documento con mucha menos intervención manual.
Adaptación a las variaciones de diseño: como los LLMs se apoyan en pistas contextuales y semánticas, se adaptan mejor a las variaciones de diseño. Tanto si un formulario etiqueta un campo como «Total Value» como «Grand Total», un LLM puede reconocer la intención detrás del dato. Por tanto, un mismo modelo puede manejar varios tipos de formulario sin reprogramación, una ventaja frente a los sistemas rígidos de OCR basados en reglas.
Retos del OCR con documentos complejos
Puntos problemáticos habituales del OCR en PDF estructurados como los formularios de aduanas:
-
Pérdida del contexto espacial: el OCR devuelve un flujo de texto sin indicadores claros de las relaciones espaciales. Agrupaciones importantes (qué valor pertenece a qué campo) pueden perderse, lo que exige lógica adicional para reensamblar los datos.
-
Tablas sin bordes o complejas: muchos documentos de negocio definen las tablas con espaciado en lugar de líneas dibujadas. Los motores de OCR suelen interpretar mal estos diseños, partiendo filas multilínea en entradas separadas o fusionando columnas adyacentes incorrectamente.
-
Campos multilínea: campos como direcciones o descripciones de producto que abarcan varias líneas son otro reto. El OCR tradicional puede tratar cada línea como una entrada distinta, rompiendo la continuidad de los datos.
-
Necesidad de mucho postprocesamiento: extraer datos estructurados de la salida cruda del OCR suele requerir reglas a medida, coincidencia de patrones y heurísticas. Esto añade complejidad y exige mantenimiento continuo a medida que los formatos de documento evolucionan.
Por qué los LLMs funcionan bien con formularios estructurados
El procesamiento basado en LLMs aborda estos retos integrando la comprensión contextual en el propio paso de extracción:
-
Extracción contextual: un LLM no solo ve palabras; lee su significado. Al interpretar el contenido como un todo, puede asociar los valores con sus campos correspondientes, reduciendo la necesidad de postprocesamiento.
-
Conservación de la estructura: con los prompts adecuados, los LLMs mantienen la agrupación de datos relacionados. Por ejemplo, los datos de cada línea de artículo de una declaración de aduanas permanecen asociados, garantizando que etiquetas y valores queden bien emparejados.
-
Manejo de variaciones de diseño: los LLMs son menos sensibles a las variaciones de formato del documento. Su flexibilidad les permite extraer la información correcta incluso cuando el diseño cambia de un documento a otro.
-
Menos reglas manuales: en lugar de escribir y mantener una miríada de scripts a medida para cada tipo de documento, los desarrolladores pueden apoyarse en un prompt bien construido para guiar al LLM. Esta simplificación reduce el trabajo de desarrollo y acelera el despliegue.
La investigación en comprensión de documentos basada en transformers muestra que combinar texto e información de diseño mejora el rendimiento de la extracción. Los modelos diseñados específicamente para el procesamiento de documentos rinden mejor con datos complejos, multilínea y tablas sin bordes.
Comparación de precisión, velocidad y eficiencia
Precisión: la extracción basada en LLMs tiende a ofrecer mayor precisión en documentos complejos. Los sistemas de OCR de última generación logran alta precisión en texto limpio, pero dejan un margen de error mayor al extraer datos estructurados. Al usar el contexto, los LLMs reducen estos errores en aplicaciones reales.
Velocidad: el OCR tradicional está optimizado para la extracción de texto en bruto y puede procesar decenas de páginas por segundo. Los métodos basados en LLMs son computacionalmente más pesados y más lentos por página, pero entregan datos estructurados directamente, eliminando la mayor parte del postprocesamiento. Para muchos flujos de trabajo empresariales, unos segundos más por documento es un precio pequeño a cambio de las ganancias en precisión y automatización.
Eficiencia y escalabilidad: el OCR consume menos recursos, lo que lo hace rentable para despliegues a gran escala. Los LLMs exigen más cómputo, pero pueden mejorar la eficiencia operativa global al reducir las correcciones manuales y las reglas de parseo a medida. Su adaptabilidad a nuevos formatos de documento sin reprogramación también se traduce en ahorros de tiempo y esfuerzo de desarrollo a largo plazo.
Impacto real en los flujos de trabajo empresariales
Para profesionales de negocio, científicos de datos y desarrolladores, la diferencia entre OCR y extracción basada en LLMs no es solo técnica: se nota en la eficiencia operativa y la calidad de los datos. Una gran autoridad aduanera que adoptó un sistema de procesamiento de documentos basado en LLMs reportó un procesamiento de formularios más rápido y una reducción clara de errores. Automatizar la extracción les permitió procesar los formularios más rápido, reducir los problemas de cumplimiento y liberar personal para tareas más complejas.
Una mayor precisión de los datos también significa menos errores aguas abajo, menos intervención manual y un acceso más rápido a datos fiables para la toma de decisiones. Donde la información oportuna y precisa importa, esas ganancias se acumulan hasta convertirse en una ventaja competitiva.
Conclusión y puntos clave
Pasar del OCR tradicional a la lectura de PDF basada en LLMs es un paso práctico adelante en el procesamiento de documentos. Puntos clave:
-
Enfoques diferentes: el OCR tradicional es eficaz en la extracción básica de texto, pero tiene dificultades con el contexto y el diseño, mientras que los LLMs leen el texto dentro de su contexto más amplio, conservando las relaciones y la integridad de los datos.
-
Integridad de los datos estructurados: en aplicaciones como los formularios de declaración de aduanas, mantener estructurados los datos de múltiples campos es crítico. Los LLMs mantienen los elementos de datos relacionados correctamente emparejados, lo que mejora la precisión global.
-
Compromisos de rendimiento: el OCR ofrece velocidad y bajo coste computacional; los LLMs ofrecen una salida más rica y precisa que a menudo justifica el tiempo de procesamiento extra. La comprensión de documentos basada en transformers sigue reduciendo los errores de extracción.
-
Impacto en los flujos de trabajo: al automatizar la extracción de documentos complejos, los sistemas basados en LLMs agilizan las operaciones, reducen las correcciones manuales y proporcionan un acceso más rápido y fiable a los datos críticos.
En resumen, el OCR tradicional sigue siendo una herramienta útil para la extracción simple de texto, pero los LLMs están demostrando ser más eficaces para los datos estructurados en documentos complejos. Para las organizaciones que trabajan con formatos de documento diversos e intrincados, el procesamiento basado en LLMs es la opción más capaz y mantenible.